数据库入门:SQL、Postgres 与 Supabase 详解
了解关系型数据库如何组织信息、SQL 如何工作,以及现代 Web 应用为何经常结合使用 Postgres 和 Supabase。本课还会介绍模式设计、安全机制,以及 Coderblock 中的实用数据库工作流。
Web 应用为什么需要数据库
应用可以显示页面、收集信息或执行操作。但如果它需要记住某些内容,该怎么办?
预订平台需要记住客户、服务和预约。 电商商店需要管理商品、订单和库存。 SaaS 平台需要知道哪些用户拥有账户、创建了哪些项目,以及具备哪些权限。
这正是数据库存在的原因。
数据库用于以结构化、持久化的方式存储应用所需的信息。 如果没有数据库,很多数据可能只会暂时存在于浏览器中,页面一旦关闭,数据就可能丢失。 有了数据库,应用便可以保存信息,并在之后通过不同设备为不同用户重新获取这些信息。
数据库就是应用的记忆
你可以把数据库理解为应用的永久记忆。
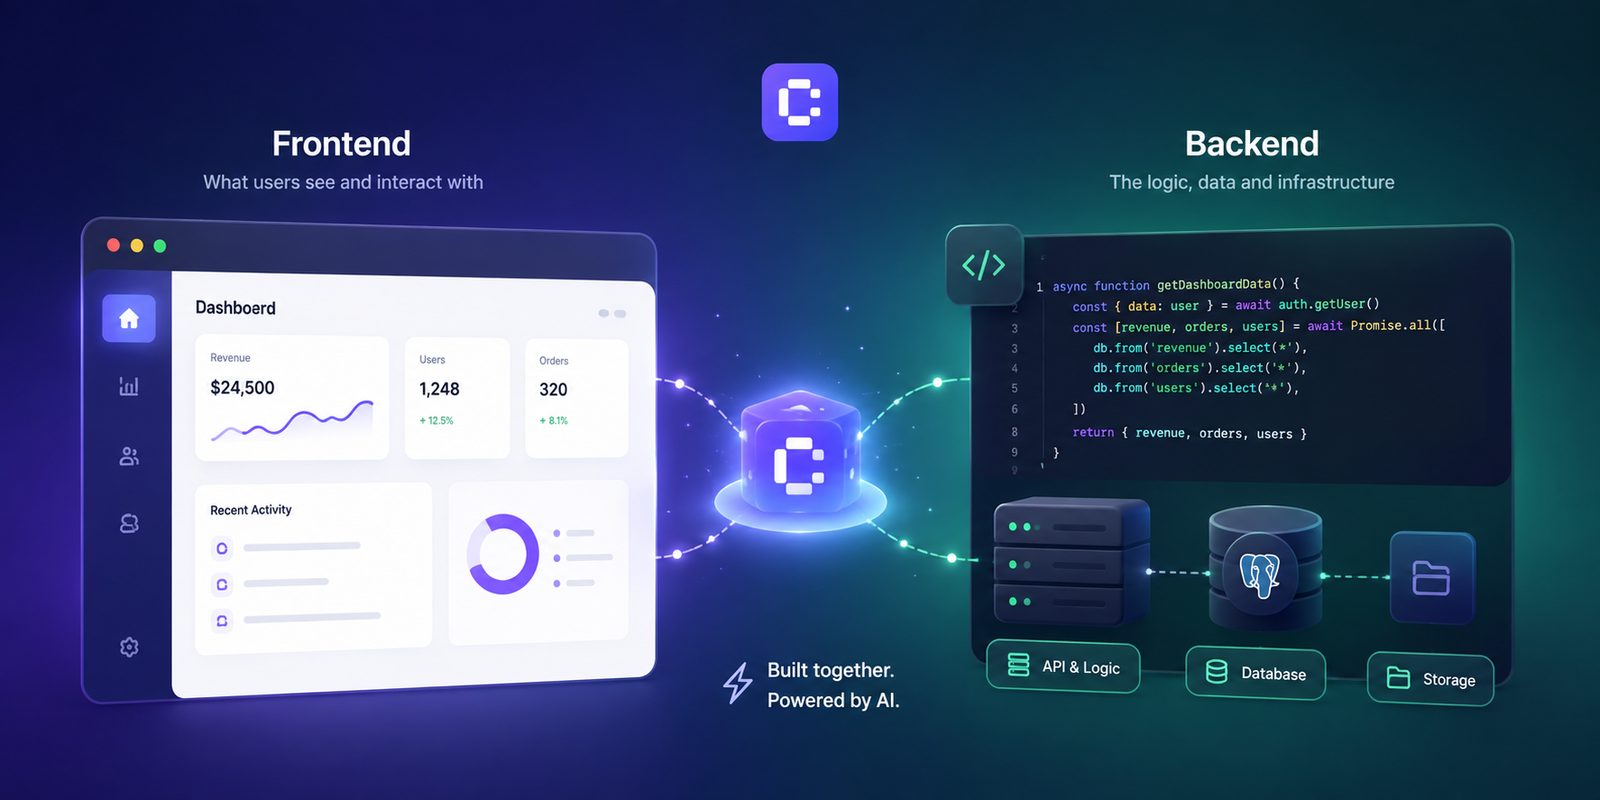
前端负责展示信息。 后端负责执行业务逻辑。 数据库负责存储数据。
以预订应用为例:
前端 → 展示服务和日历 后端 → 检查可用时间和权限 数据库 → 存储用户、服务和预约
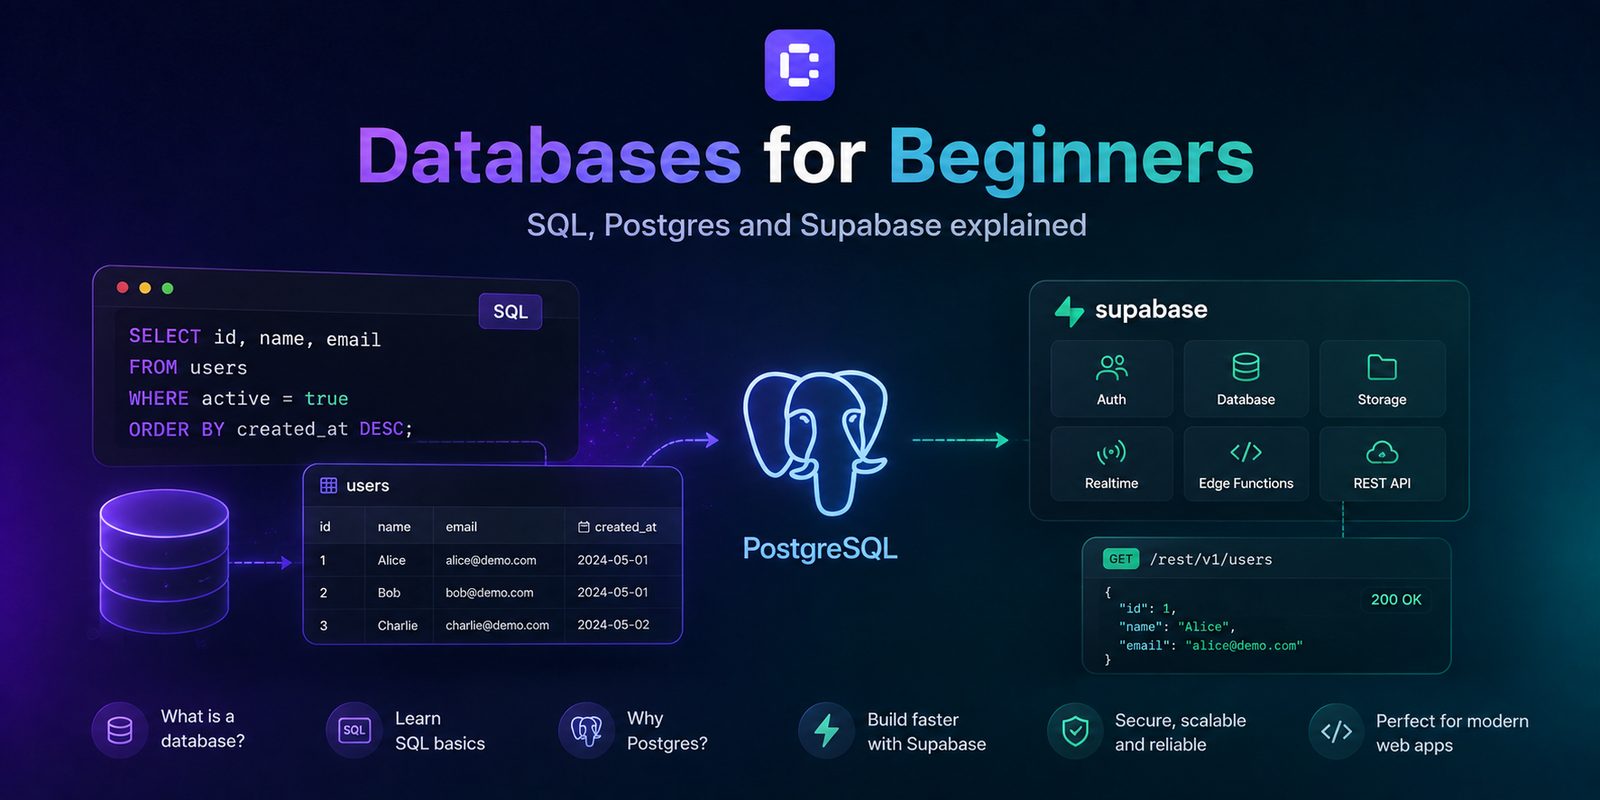
数据库有多种类型。文档数据库使用结构灵活的文档,键值数据库针对特定的快速访问场景进行了优化,而关系型数据库则通过相互关联的表来组织数据。 SQL 和 Postgres 主要属于关系型数据库领域。Supabase 则以 Postgres 为基础,为 Web 应用提供一整套后端服务。
关系型数据库:表、行与关系
关系型数据库通过表来组织信息。 每张表通常代表一种实体。 在预订平台中,你可能会有:
profiles→ 用户;services→ 可用服务;bookings→ 预约。
每张表中通常包含:
- 列,用于描述数据的属性;
- 行,代表一条条具体记录;
- 主键,用于唯一标识每条记录;
- 外键,用于关联不同表中的记录;
- 约束,用于防止无效数据被保存。
例如,一条预约记录可能包含 profile_id 和 service_id。
这样无需在每条预约记录中重复保存完整的用户和服务信息,也能准确知道是谁进行了预约,以及选择了哪项服务。
为什么关系很重要?
假设某项服务更改了名称。 如果每条预约中都复制了一份服务名称,你就需要更新成百上千条记录。 在关系型数据库中,预约只需引用正确的服务记录即可。 因此,数据之间的关系既能减少重复和不一致,也能让产品模型更加清晰有序。
什么是数据库模式?
创建数据库之前,你需要确定如何组织信息。 用于定义这一结构的表、列、关系、数据类型和约束的集合称为数据库模式(schema)。 良好的模式设计意味着数据库结构能够真实反映产品的运行方式。
创建新表之前,可以先问自己:
- 每条记录代表什么?
- 哪些信息是必填的?
- 哪些值必须唯一?
- 哪些实体之间需要建立关联?
- 谁可以读取或修改这些数据?
目标并不是创建尽可能多的表。 如果把完全不同类型的信息都塞进一张巨大的表中,维护会变得非常困难。反过来,如果把每一小块数据都拆成单独的表,系统也会变得过度复杂。
好的模式需要在数据一致性、查询简洁性与产品的真实需求之间取得平衡。
什么是 SQL?
这就要说到 SQL,即 Structured Query Language(结构化查询语言)。 SQL 是一种用于与许多关系型数据库交互的语言。
你可以用它来:
- 创建数据结构;
- 读取数据;
- 添加记录;
- 修改信息;
- 删除记录;
- 关联不同表中的数据。
四种基本操作通常用缩写 CRUD 表示:
- Create → 创建
- Read → 读取
- Update → 更新
- Delete → 删除
一个简单示例
假设我们想获取某位用户创建的所有预约。 SQL 查询可能如下:
SELECT id, start_time, status
FROM bookings
WHERE profile_id = 42
ORDER BY start_time;
用自然语言来说,这段查询表示:
“获取用户 42 的所有预约 ID、时间和状态,并按时间排序。”
SQL 还可以组合来自不同表的信息。 例如:
SELECT bookings.start_time, services.name
FROM bookings
JOIN services ON services.id = bookings.service_id;
这条查询将预约与对应的服务关联起来,从而同时返回服务名称和预约时间。
SQL 是声明式语言
SQL 的一个重要特点是它属于声明式语言。 你通常不需要逐步说明数据库应该如何查找某项信息。 你只需告诉它想要什么结果,数据库便会自行决定如何执行查询。
SQL 也是广泛使用的标准,不过不同数据库系统可能会提供各自的功能和扩展。 你不必一次学会所有内容。 掌握 SELECT、筛选条件、JOIN、分组、约束和事务等概念,就足以打下扎实的基础。
什么是 Postgres?
这里需要明确一个重要区别: SQL 是语言,Postgres 是数据库。
Postgres,更准确地说是 PostgreSQL,是一款开源关系型数据库管理系统。 它负责存储数据、执行约束并解析 SQL 查询。
你可以这样理解两者的关系:
SQL → 用于沟通的语言 Postgres → 存储和管理数据的系统
Postgres 支持多项重要功能,例如:
- 主键和外键
- 事务
- 索引
- 视图
- 约束
- 高级数据类型
为什么事务很重要?
假设有一家电商商店。 当客户购买商品时,系统可能需要:
- 创建订单;
- 扣减库存;
- 记录付款。
这些操作彼此关联。 如果第一步成功但第二步失败,就可能出现订单已经记录、库存却没有更新的情况。
事务可以将多个操作视为一个整体:要么全部成功完成,要么由数据库恢复到之前的状态。
索引又是什么?
索引可以加快某些查询。 如果应用经常需要查找某位用户在特定日期的预约,索引就能显著提高查询效率。 但索引并不是没有成本:它会占用空间,而且每次修改数据时都需要进行额外处理。
因此,为每一列自动建立索引并不是最佳实践。 索引应该服务于产品中真实存在的查询模式。
什么是 Supabase?
如果说 Postgres 是数据库,那么 Supabase 就是围绕 Postgres 构建的后端平台。 它并不会取代 Postgres。
相反,它增加了构建 Web 应用时经常需要的一系列服务,包括:
- 身份认证和会话管理;
- 文件存储;
- 数据库管理工具;
- 服务端函数;
- 数据 API;
- 行级安全策略(Row Level Security)。
最需要记住的区别是:
SQL 是语言。Postgres 是数据库。Supabase 是使用 Postgres,并为应用开发提供额外服务的后端平台。
这一组合尤其适合 Web 应用,因为你可以在集成式基础设施中统一管理数据、用户、文件和权限。
身份认证与授权:两个不同的概念
这里也需要区分两个概念。 **身份认证(Authentication)**回答的是:
“这位用户是谁?”
**授权(Authorization)**回答的是:
“这位用户可以做什么?”
Supabase Auth 可以处理注册、登录和会话。 **行级安全策略(Row Level Security,RLS)**则可以决定特定用户能够读取或修改数据库中的哪些行。 以预订平台为例。 客户应该只能看到:
自己的预约。
而管理员则可能能够看到:
所有预约。
两者都是已通过身份认证的用户,但拥有不同的权限。
安全不能只依赖前端
在界面中隐藏按钮,并不能真正阻止某人执行相关操作。 用户仍然可以尝试直接向后端发送请求。
因此,访问规则必须在后端和数据库中强制执行,而不能只依靠界面。 这正是行级安全策略的重要价值:它允许你直接在数据库层定义访问规则。
数据库在 Coderblock 中如何工作
在标准的 Coderblock Web 应用中,每个项目都有专属的 Supabase 环境,其中包含 Postgres、Auth、Storage、Deno Edge Functions 和 Row Level Security。 系统默认还会提供基础的用户资料结构和初始角色系统。
不同之处在于,你不一定需要从手动配置数据库开始。 你可以直接通过聊天描述想要构建的内容。
例如:
“添加服务,并为每项服务设置时长、价格和启用状态。”
然后:
“创建与已登录用户关联的预约。”
接着:
“禁止客户查看其他客户的预约,并创建一个可管理全部预约的管理员视图。”
智能体可以设计模式、应用迁移、连接 React 前端与后端,并配置所需的 RLS 策略。 之后,你可以在编辑器的 Backend 区域查看数据表、已认证用户、存储和函数。
当你继续通过对话修改应用时,实时预览也会同步更新。
最好的提示词不是“创建一个数据库”
使用 AI 应用构建工具时,只提出以下要求是不够的:
“为预订应用创建一个数据库。”
更有效的做法是描述产品模型。 请明确说明:
- 主要实体;
- 每个实体应包含哪些信息;
- 实体之间如何关联;
- 哪些字段是必填的;
- 哪些用户可以访问数据;
- 这些用户可以执行哪些操作。
这样,AI 才能获得足够的信息,把产品描述转化为一致的数据结构。
适合初学者的数据库最佳实践
即使你不是数据库工程师,也可以避开最常见的错误。
使用稳定的标识符
每张重要的数据表都应该有一个主键。 避免把姓名或电子邮箱等信息用作永久标识符,因为这些信息可能会发生变化。
让规则靠近数据
前端验证有助于改善用户体验,但不应该成为唯一的保护措施。 请使用:
- 必填字段;
- 唯一约束;
- 外键;
- 合适的数据类型;
- 访问策略。
这样,无论请求来自哪里,数据库都能保护数据完整性。
遵循最小权限原则
每位用户都应该只拥有完成其任务所需的权限。 请使用不同角色测试应用:
- 匿名访客;
- 已认证用户;
- 管理员。
务必确认每种角色能够读取、创建、修改或删除哪些内容。
通过迁移管理模式
数据库会随着产品一起变化。 添加新功能时,你可能需要创建数据表、添加列或修改关系。 使用受控迁移可以追踪这些变更,并降低现有数据丢失的风险。 删除列或更改结构之前,务必确认它已不再被使用。
对产品建模,而不是对页面建模
这可能是最重要的一条规则。 数据表应该代表一个真实的产品概念,而不只是界面中的某个页面。 仪表盘的设计可能会彻底改变,但客户、预约或订单依然代表同样的实体。 优先思考数据模型,也能让未来的前端演进更加容易。
SQL、Postgres 与 Supabase:真正需要记住的内容
如果你刚刚入门,不需要背下几十个术语。
只需记住以下关系:
SQL → 用于查询和修改数据的语言 Postgres → 存储数据并执行查询的关系型数据库 Supabase → 使用 Postgres,并提供身份认证、存储、API、函数和 Web 应用开发工具的后端平台
在 Coderblock 中,这些概念已经融入应用构建流程。 你可以用自然语言描述应用需要记住什么、数据之间应该如何关联,以及谁可以访问这些数据。智能体可以完成全栈实现,而你则可以通过聊天查看并持续完善结果。
因此,理解数据库的工作方式能帮助你完成一件更重要的事:更清楚地描述自己想要构建什么。 你不一定需要亲自编写 SQL,但理解表、关系、角色、约束和权限,可以帮助你把想法变成一个不只是展示数据,而是真正能够存储、关联并保护数据的应用。