前端与后端:AI 应用构建器究竟会生成什么
精美的界面并不等于完整的应用。了解前端与后端生成分别涉及哪些内容、两者如何协同工作,以及选择 AI 应用构建器时应该检查什么。
一个界面还不能算是应用
AI 应用构建器可以在几分钟内把一段简单的描述转化为可操作的界面。
但当我们说 AI 已经“构建了一个应用”时,究竟意味着什么?并非所有构建器生成的结果都一样。 有些工具主要生成 UI:页面、按钮、表单和可视化组件,方便你验证创意或制作原型。另一些工具还会生成将界面连接到真实数据和外部服务所需的代码。
而一个 全栈 构建器需要处理更多内容:前端、后端、数据库、身份认证、授权和部署。 因此,要判断 AI 构建器究竟创建了什么,理解前端与后端的区别至关重要。更重要的是,这有助于你写出更好的提示词,并在项目投入生产环境前发现缺失环节。
前端会生成什么
前端 是用户在浏览器中直接看到并与之交互的一切。
它可以包括:
- 页面、菜单、表单、按钮、模态框和表格;
- 适配桌面端和移动端的响应式布局;
- 用户输入验证;
- 加载、错误、成功和空状态;
- 对后端服务的调用;
- 与会话相关的元素,例如账户菜单和设置;
- 本地界面状态,例如当前选中的筛选条件或已打开的窗口。
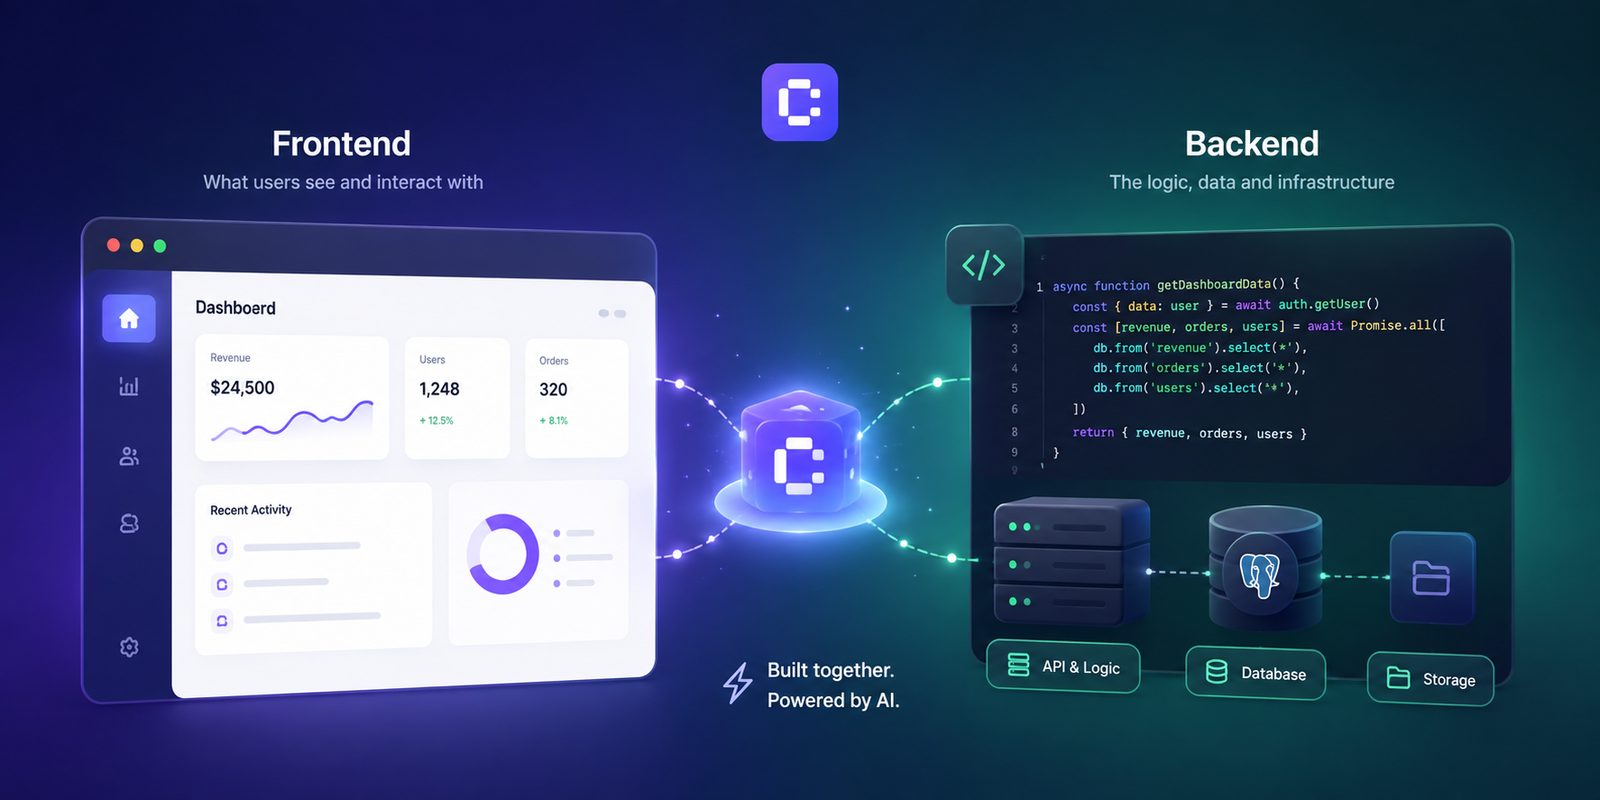
Coderblock 生成的前端使用 React、Vite、TypeScript 和 Tailwind CSS。例如,假设你让它创建一个服务预约平台,前端可以生成服务目录、可预约日历、预约表单、客户账户区域和管理后台。
乍看之下,它可能已经像一个完整的产品。但这里有一个重要区别:界面看起来可以使用,并不代表它真的具备相应功能。 按钮可以在点击时做出响应,却没有保存任何数据。仪表盘可以显示直接硬编码在应用中的信息。表单也可以显示成功消息,却并未真正创建预约。
这些元素对于原型都很有用,但还不足以构成一个可正式使用的应用。
仅靠前端验证是不够的
举个简单的例子:预约表单可能会阻止用户选择过去的日期。 这是一项良好的用户体验规则,但并不是安全措施。
在浏览器中执行的规则可以被修改或绕过。因此,后端必须在接受并保存请求前再次进行验证。 价格、权限、库存、用户角色和订阅 同样如此。 前端负责传达用户想做什么,后端则决定是否真的允许执行该操作。
后端会生成什么
如果说前端是应用中可见的部分,那么 后端 负责管理不能依赖浏览器的数据、规则和操作。
一个完整的后端可以处理:
- 数据库表、字段、关系和索引;
- 身份认证与会话管理;
- 不同用户和角色的权限;
- 服务端验证与业务规则;
- 文件存储;
- 与支付服务或 AI 服务的集成;
- 使用凭据和私密信息的函数。
在 Coderblock 的标准 Web 应用中,每个项目都会获得一个独立的 Supabase 环境,其中包含 Postgres、Supabase Auth、Storage 和 Deno Edge Functions。 而 Enterprise Web Platform 项目使用 Python 和 FastAPI,并配备 Neon Postgres 数据库。
通过对话构建数据库
AI 应用构建器的一项优势是,你不一定需要先手动编写数据库架构。你可以直接在提示词中描述自己的需求。
例如:
“添加预约功能,每条预约需要包含客户、服务、开始时间、状态和总价。客户只能查看自己的预约,而管理员可以查看全部预约。”
面对这样的请求,智能体可以设计所需的表和关系,将它们连接到界面,并配置访问规则。 这正是生成 UI 与构建真实应用之间的关键区别:数据不能只是出现在屏幕上,还必须具备结构、持久性,以及符合产品需求的规则。
身份认证:只有登录页面是不够的
包含邮箱字段、密码字段和“登录”按钮的页面,本身并不构成身份认证系统。 完整的身份认证还需要:
- 会话管理;
- 受保护的路由;
- 授权;
- 数据库访问控制;
- 安全处理凭据和账户数据。
当你让 Coderblock 添加账户和身份认证时,智能体会配置 Supabase Auth,包括注册与登录、邮箱和密码认证、会话管理、受保护的路由,以及 Postgres 行级安全策略(RLS)。你也可以要求添加社交账号登录。 应用还会包含专用的用户资料表,以及用于角色管理的基础结构。
你不需要手动创建密码表,也不必让 AI 从头实现 JWT 和哈希处理。 Supabase Auth 负责身份认证,而行级安全策略则定义每位用户实际可以查看或修改哪些数据。
前端与后端如何协同工作
为了理解两者的区别,可以想象一次预约的完整流程。
- 用户在 React 表单中填写服务、日期和时间。
- 前端检查输入的数据是否有效。
- 应用将请求发送到后端。
- 后端验证用户身份,并再次校验数据。
- 如果请求已获授权,Postgres 就会保存预约。
- 前端接收响应并更新界面。
每一层都有不同的职责。 前端 必须快速、清晰且响应灵敏。 后端 必须可靠、安全且保持一致。
支付又该如何处理?
同样的原则也适用于支付。 “结账”按钮属于前端,但价格、交易和支付凭据不能直接在浏览器中处理。 在 Coderblock 中,你可以通过聊天配置支付功能。智能体会询问国家和企业名称等信息,然后创建托管的 Stripe 账户,无需用户手动配置 API 密钥。平台还会处理 webhook。你也可以通过安全的环境变量请求连接自己的 Stripe 账户。
无论采用哪种方式,敏感信息都会保留在项目的服务器环境中,绝不会被放入前端代码或对话里。
UI 生成器还是全栈 AI 构建器?
并非所有项目都需要同等程度的基础设施。
UI 生成器 非常适合探索设计方案、将想法转化为原型,或创建静态落地页。在这些场景中,你不必立即构建数据库、身份认证和授权系统。
但如果你想创建一个管理真实用户和数据的产品,情况就不同了。 当应用需要以下功能时,全栈 AI 应用构建器 尤其有用:
- 持久化数据;
- 账户和身份认证;
- 私密信息;
- 角色和权限;
- 支付;
- 文件上传;
- 管理后台;
- 与外部服务集成。
要弄清楚自己究竟生成了什么,不要只问:“这个界面看起来完整吗?” 你还应该思考:
- 是否存在真实的数据库?
- 数据是否真的被保存?
- 用户是否只能看到自己有权查看的内容?
- 敏感操作是否在服务器端执行?
- 私密凭据是否受到保护?
- 从预览到生产环境是否有清晰的发布路径?
在 Coderblock 中,前端和后端会一起生成。你可以通过 coderblock.dev 上的专属开发环境实时查看应用,同时在 Backend 部分检查数据表、已认证用户、存储和函数。
这意味着,你不仅可以评估屏幕上显示的内容,还能检查支撑界面正常运行的底层能力。
如何为 AI 应用构建器写出更好的提示词
生成结果的质量,也取决于你能否清楚描述自己期望应用具备的行为。
明确定义角色和数据归属
不要只写:
“创建一个任务管理应用。”
你需要说明谁会使用该应用,以及他们可以查看或修改哪些数据。 例如:
“成员可以创建和编辑自己的任务。经理可以查看分配给其团队的所有任务。”
更精确的要求可以为智能体提供设计界面和访问规则所需的信息。
描述数据的完整生命周期
说明应用中的每一项数据可以经历哪些操作。 它可以被创建、编辑、归档或删除吗? 你还应定义必填字段、数据之间的关系、状态变化,以及删除关联记录时应该发生什么。
也要考虑错误场景
应用不能只在一切顺利时正常工作。 你的提示词还可以说明出现以下情况时应该如何处理:
- 支付失败;
- 用户不具备所需权限;
- 请求失败;
- 没有可显示的数据;
- 某项操作需要较长时间才能完成。
加载状态、错误消息、空状态和成功反馈,与主要页面一样,都是产品体验的重要组成部分。
测试功能行为,而不只是检查设计
应用生成后,不要只是看一看,而要真正进行测试。 使用不同的账户和角色进行操作。刷新页面,确认数据仍然保留。尝试访问本应保密的信息。尝试执行特定角色不该拥有权限的操作。当然,也要检查应用在移动设备上的表现。
应用并不会因为看起来完整就已经准备就绪。只有当它的工作流程真正可用时,才算准备完成。
从生成的技术栈到正式发布的产品
生成初始结果只是起点。 借助实时预览,你可以测试应用的工作流程,并继续使用自然语言修改应用。 例如,你可以提出:
“让导航栏在滚动时固定在顶部。”
“添加一张显示所有预约的管理员表格。”
“阻止客户预约已被占用的时间段。”
你不必为了每一次修改都回到代码中。只需继续描述自己的需求,让智能体更新项目即可。
应用准备就绪后,Coderblock 支持一键发布到专属的 coderblock.app 地址,并包含 SSL。
你还可以按照引导完成 DNS 设置,从而连接现有域名;也可以直接通过平台购买域名,并自动完成 DNS 和 SSL 配置。
不要只看第一个界面
评估 AI 应用构建器的最佳方式很简单:不要只停留在你能看到的部分。 精美的 UI 确实重要,但它本身并不构成完整的应用。 真正的全栈成果,会把易用的前端与 持久化数据、身份认证、授权、后端逻辑、安全集成,以及清晰的生产发布路径 连接起来。这正是生成一个界面与构建一个应用之间的区别。 而在使用 AI 应用构建器时,这也是点击“发布”之前最需要考虑的因素之一。