Les bases de données pour débutants : comprendre SQL, Postgres et Supabase
Découvrez comment les bases de données relationnelles organisent l’information, comment fonctionne SQL et pourquoi Postgres et Supabase sont souvent utilisés ensemble dans les applications web modernes. Cette leçon aborde également la conception de schémas, la sécurité et les workflows pratiques de gestion des bases de données dans Coderblock.
Pourquoi les applications web ont besoin de bases de données
Une application peut afficher un écran, recueillir des informations ou effectuer une action. Mais que se passe-t-il lorsqu’elle doit se souvenir de quelque chose ?
Une plateforme de réservation doit mémoriser les clients, les services et les rendez-vous. Une boutique en ligne doit gérer les produits, les commandes et les stocks. Une plateforme SaaS doit savoir quels utilisateurs possèdent un compte, quels projets ils ont créés et de quelles autorisations ils disposent.
C’est précisément pour cela que les bases de données existent.
Une base de données permet à une application de stocker les informations dont elle a besoin de manière structurée et durable. Sans base de données, une grande partie de ces données pourrait n’exister que temporairement dans le navigateur. Dès que la page serait fermée, elles pourraient être perdues. Avec une base de données, l’application peut enregistrer des informations et les récupérer ultérieurement, depuis différents appareils et pour différents utilisateurs.
Une base de données est la mémoire de l’application
Vous pouvez considérer une base de données comme la mémoire permanente d’une application.
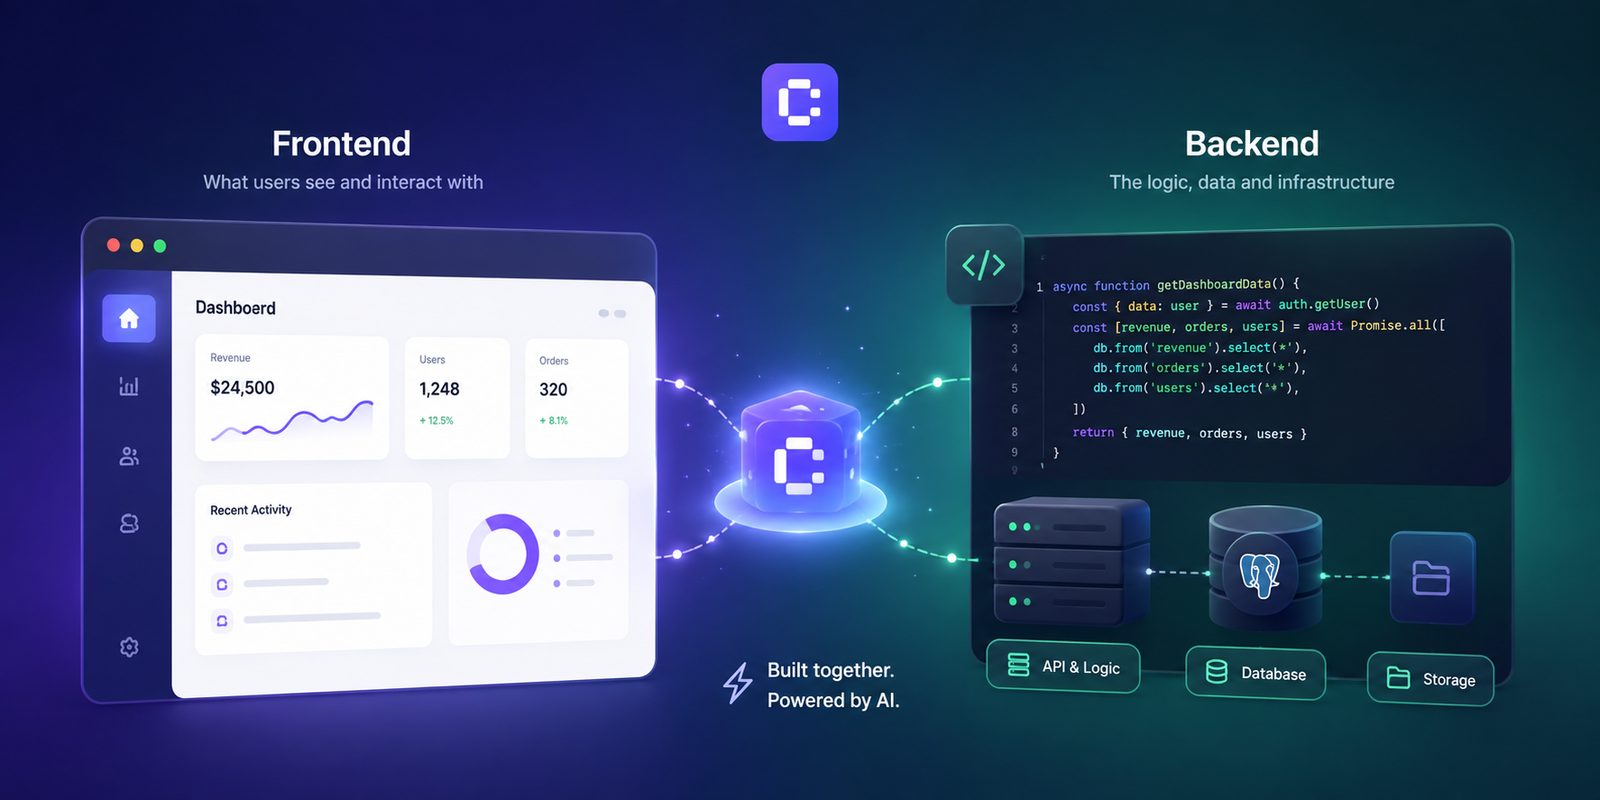
Le frontend affiche les informations. Le backend applique la logique. La base de données stocke les données.
Dans une application de réservation, par exemple :
Frontend → affiche les services et le calendrier Backend → vérifie les disponibilités et les autorisations Base de données → stocke les utilisateurs, les services et les réservations
Il existe plusieurs types de bases de données. Les bases documentaires utilisent des documents flexibles, les bases clé-valeur sont optimisées pour certains types d’accès rapides, tandis que les bases de données relationnelles organisent les données dans des tables reliées entre elles. SQL et Postgres appartiennent principalement à cette dernière catégorie. Supabase, de son côté, s’appuie sur Postgres pour proposer un ensemble de services backend destinés aux applications web.
Bases de données relationnelles : tables, lignes et relations
Une base de données relationnelle organise les informations dans des tables. Chaque table représente généralement un type d’entité. Dans une plateforme de réservation, vous pourriez avoir :
profiles→ les utilisateurs ;services→ les services disponibles ;bookings→ les réservations.
Chaque table contient :
- des colonnes, qui décrivent les propriétés des données ;
- des lignes, qui représentent les enregistrements individuels ;
- des clés primaires, qui identifient chaque enregistrement de manière unique ;
- des clés étrangères, qui relient des enregistrements provenant de différentes tables ;
- des contraintes, qui empêchent l’enregistrement de données non valides.
Par exemple, une réservation peut contenir un profile_id et un service_id.
Vous savez ainsi exactement qui a effectué la réservation et quel service a été choisi, sans avoir à recopier toutes les informations de l’utilisateur et du service dans chaque réservation.
Pourquoi les relations sont-elles importantes ?
Imaginez qu’un service change de nom. Si ce nom était copié dans chaque réservation, vous devriez mettre à jour des centaines, voire des milliers d’enregistrements. Avec une base de données relationnelle, chaque réservation peut simplement faire référence au service concerné. Les relations entre les données permettent donc de réduire les doublons et les incohérences, tout en conservant un modèle produit mieux organisé.
Qu’est-ce qu’un schéma de base de données ?
Avant de créer une base de données, vous devez déterminer comment organiser les informations. L’ensemble des tables, colonnes, relations, types de données et contraintes qui définit cette structure s’appelle un schéma. Bien concevoir un schéma consiste à faire en sorte que la base de données reflète le fonctionnement réel du produit.
Avant de créer une nouvelle table, posez-vous les questions suivantes :
- Que représente chaque enregistrement ?
- Quelles informations sont obligatoires ?
- Quelles valeurs doivent être uniques ?
- Quelles entités doivent être reliées ?
- Qui peut consulter ou modifier ces données ?
L’objectif n’est pas de créer autant de tables que possible. Une seule table gigantesque contenant des informations de natures totalement différentes peut devenir difficile à gérer. À l’inverse, placer chaque petite donnée dans une table distincte peut inutilement complexifier le système.
Un bon schéma trouve un équilibre entre la cohérence des données, la simplicité des requêtes et les besoins réels du produit.
Qu’est-ce que SQL ?
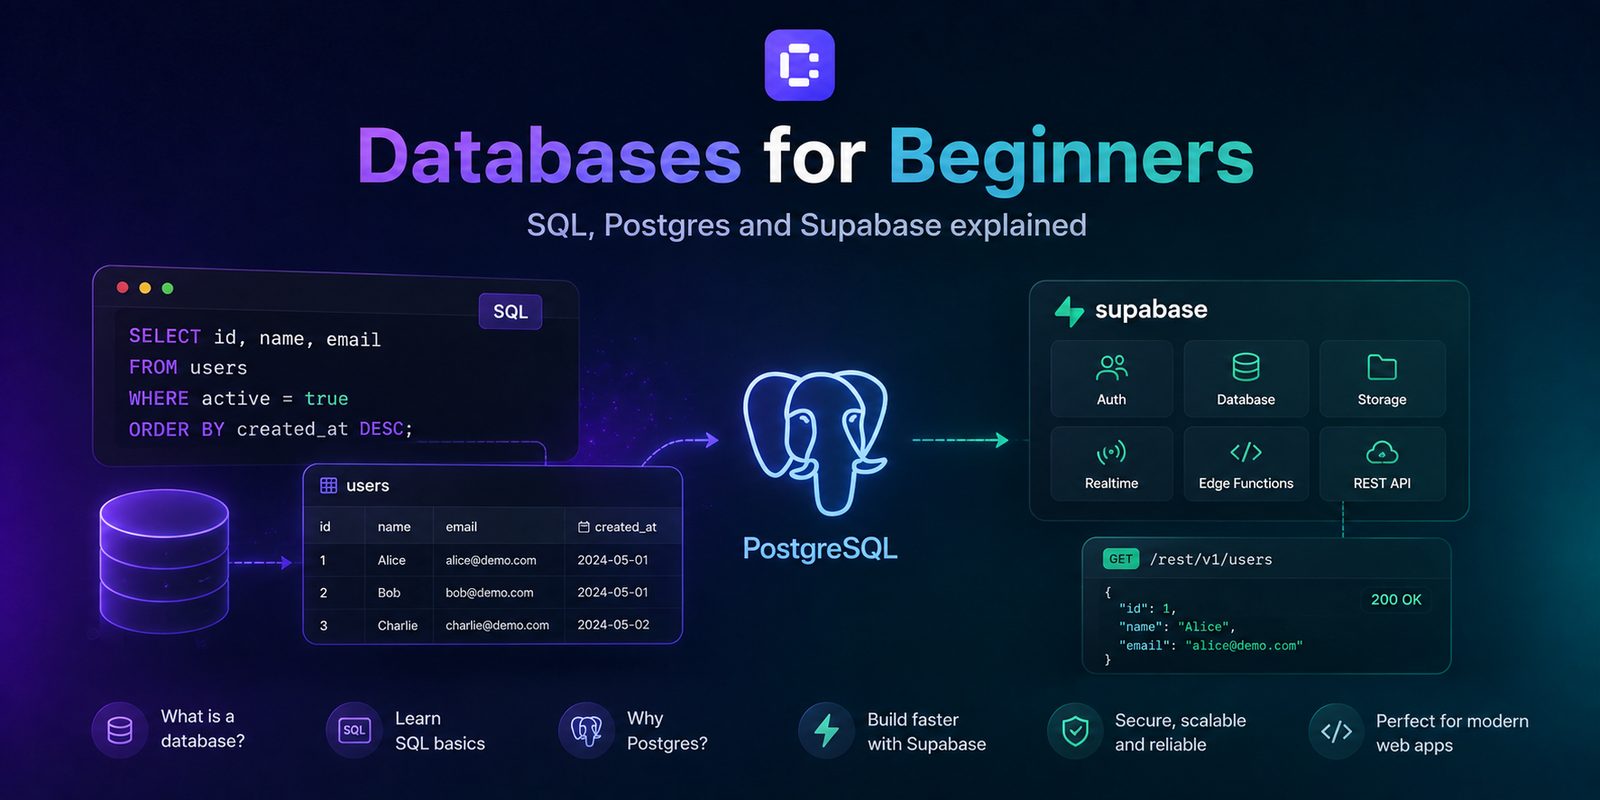
C’est ici qu’intervient SQL, acronyme de Structured Query Language, ou langage de requête structuré. SQL est le langage utilisé pour interagir avec de nombreuses bases de données relationnelles.
Vous pouvez l’utiliser pour :
- créer des structures ;
- lire des données ;
- ajouter des enregistrements ;
- modifier des informations ;
- supprimer des enregistrements ;
- relier les données de différentes tables.
Les quatre opérations fondamentales sont souvent regroupées sous l’acronyme CRUD :
- Create → créer
- Read → lire
- Update → mettre à jour
- Delete → supprimer
Un exemple simple
Supposons que nous souhaitions récupérer les réservations effectuées par un utilisateur précis. Une requête SQL pourrait ressembler à ceci :
SELECT id, start_time, status
FROM bookings
WHERE profile_id = 42
ORDER BY start_time;
Concrètement, nous demandons :
« Donne-moi les identifiants, les horaires et les statuts des réservations de l’utilisateur 42, classés par heure. »
SQL peut également combiner les informations de plusieurs tables. Par exemple :
SELECT bookings.start_time, services.name
FROM bookings
JOIN services ON services.id = bookings.service_id;
Cette requête relie les réservations aux services correspondants afin de renvoyer le nom du service avec l’heure de la réservation.
SQL est déclaratif
Une caractéristique importante de SQL est qu’il s’agit d’un langage déclaratif. Vous n’avez pas nécessairement besoin de détailler chaque étape que la base de données doit suivre pour trouver une information. Vous lui indiquez le résultat souhaité, puis la base de données détermine comment exécuter la requête.
SQL est également un standard très répandu, même si les différents systèmes peuvent proposer leurs propres fonctionnalités et extensions. Vous n’avez pas besoin de tout apprendre immédiatement. Comprendre des concepts comme SELECT, les filtres, les JOIN, les regroupements, les contraintes et les transactions suffit déjà à acquérir des bases solides.
Qu’est-ce que Postgres ?
Il est important de faire ici une distinction : SQL est le langage. Postgres est la base de données.
Postgres, ou plus précisément PostgreSQL, est un système de gestion de base de données relationnelle open source. C’est le logiciel qui stocke les données, applique les contraintes et interprète les requêtes SQL.
Vous pouvez résumer leur relation ainsi :
SQL → le langage que vous utilisez pour communiquer Postgres → le système qui stocke et gère les données
Postgres prend en charge des fonctionnalités essentielles telles que :
- les clés primaires et les clés étrangères
- les transactions
- les index
- les vues
- les contraintes
- les types de données avancés
Pourquoi les transactions sont-elles importantes ?
Imaginez une boutique en ligne. Lorsqu’un client achète un produit, le système peut devoir :
- créer la commande ;
- réduire le stock ;
- enregistrer le paiement.
Ces opérations sont liées. Si la première réussit, mais que la deuxième échoue, vous pourriez vous retrouver avec une commande enregistrée alors que le stock n’a jamais été mis à jour.
Les transactions permettent de traiter plusieurs opérations comme une seule unité : soit elles aboutissent toutes, soit la base de données peut restaurer l’état précédent.
Et les index ?
Les index accélèrent certaines recherches. Si une application doit régulièrement retrouver les réservations d’un utilisateur à une date précise, un index peut rendre cette opération bien plus efficace. Mais les index ont un coût : ils occupent de l’espace et nécessitent un travail supplémentaire chaque fois que les données sont modifiées.
C’est pourquoi indexer automatiquement chaque colonne n’est pas une bonne pratique. Un index doit correspondre à un véritable modèle de requête utilisé dans le produit.
Qu’est-ce que Supabase ?
Si Postgres est la base de données, Supabase est une plateforme backend construite autour de Postgres. Elle ne remplace pas Postgres.
Elle ajoute plutôt un ensemble de services couramment nécessaires à la création d’applications web, notamment :
- l’authentification et la gestion des sessions ;
- le stockage de fichiers ;
- des outils d’administration de bases de données ;
- des fonctions côté serveur ;
- des API de données ;
- la Row Level Security.
La distinction la plus importante à retenir est la suivante :
SQL est le langage. Postgres est la base de données. Supabase est une plateforme backend qui utilise Postgres et ajoute des services pour créer des applications.
Cette combinaison est particulièrement utile pour les applications web, car elle permet de gérer les données, les utilisateurs, les fichiers et les autorisations au sein d’une infrastructure intégrée.
Authentification et autorisation : deux notions différentes
Là encore, il est utile de distinguer deux concepts. L’authentification répond à la question :
« Qui est cet utilisateur ? »
L’autorisation répond à la question :
« Qu’a-t-il le droit de faire ? »
Supabase Auth peut gérer l’inscription, la connexion et les sessions. La Row Level Security (RLS), ou sécurité au niveau des lignes, peut déterminer quelles lignes de la base de données un utilisateur donné est autorisé à consulter ou à modifier. Imaginez une plateforme de réservation. Un client doit pouvoir voir :
ses propres réservations.
Un administrateur, en revanche, peut être autorisé à voir :
toutes les réservations.
Les deux sont des utilisateurs authentifiés, mais ils disposent d’autorisations différentes.
La sécurité ne peut pas reposer uniquement sur le frontend
Masquer un bouton dans l’interface n’empêche pas quelqu’un d’effectuer une opération. Un utilisateur pourrait essayer d’envoyer une requête directement au backend.
Les règles d’accès doivent donc être appliquées dans le backend et dans la base de données, et pas seulement dans l’interface. C’est là que la Row Level Security devient importante : elle permet de définir les règles d’accès directement au niveau de la base de données.
Comment fonctionnent les bases de données dans Coderblock
Dans les applications web Coderblock standard, chaque projet dispose d’un environnement Supabase dédié comprenant Postgres, Auth, Storage, Deno Edge Functions et Row Level Security. Une structure de profils de base et un système initial de rôles sont également inclus par défaut.
La différence est que vous n’avez pas nécessairement besoin de commencer par configurer manuellement la base de données. Vous pouvez décrire ce que vous souhaitez créer dans le chat.
Par exemple :
« Ajoute des services avec une durée, un prix et un statut actif. »
Puis :
« Crée des réservations associées aux utilisateurs authentifiés. »
Et ensuite :
« Empêche les clients de voir les réservations des autres clients et crée une vue administrateur permettant de toutes les gérer. »
L’agent peut concevoir le schéma, appliquer les migrations, connecter le frontend React au backend et configurer les politiques RLS nécessaires. Dans la section Backend de l’éditeur, vous pouvez ensuite consulter les tables, les utilisateurs authentifiés, le stockage et les fonctions.
L’aperçu en direct se met à jour à mesure que vous continuez à modifier l’application au fil de la conversation.
Le meilleur prompt n’est pas « crée une base de données »
Lorsque vous utilisez un outil de création d’applications basé sur l’IA, il ne suffit pas de demander :
« Crée une base de données pour une application de réservation. »
Il est bien plus utile de décrire le modèle du produit. Précisez :
- les principales entités ;
- les informations qu’elles doivent contenir ;
- la manière dont elles sont reliées ;
- les champs obligatoires ;
- les utilisateurs autorisés à accéder aux données ;
- les actions qu’ils peuvent effectuer.
Vous fournissez ainsi à l’IA les informations nécessaires pour transformer la description d’un produit en une structure de données cohérente.
Bonnes pratiques pour débuter avec les bases de données
Vous n’avez pas besoin d’être spécialiste des bases de données pour éviter les erreurs les plus courantes.
Utilisez des identifiants stables
Chaque table importante doit avoir une clé primaire. Évitez d’utiliser des données comme les noms ou les adresses e-mail en tant qu’identifiants permanents, car elles peuvent changer.
Placez les règles au plus près des données
La validation dans le frontend améliore l’expérience utilisateur, mais elle ne doit pas constituer l’unique protection. Utilisez :
- des champs obligatoires ;
- des contraintes d’unicité ;
- des clés étrangères ;
- des types de données adaptés ;
- des politiques d’accès.
La base de données peut ainsi protéger l’intégrité des données, quelle que soit l’origine de la requête.
Respectez le principe du moindre privilège
Chaque utilisateur doit disposer uniquement des autorisations nécessaires pour accomplir ses tâches. Testez l’application avec différents rôles :
- visiteur anonyme ;
- utilisateur authentifié ;
- administrateur.
Vérifiez toujours ce que chaque rôle peut consulter, créer, modifier ou supprimer.
Gérez le schéma à l’aide de migrations
Les bases de données évoluent en même temps que les produits. Lorsque vous ajoutez une nouvelle fonctionnalité, vous pouvez avoir besoin de créer une table, d’ajouter une colonne ou de modifier une relation. L’utilisation de migrations contrôlées permet de suivre ces changements et réduit le risque de perdre des données existantes. Avant de supprimer une colonne ou de modifier une structure, assurez-vous toujours qu’elle n’est plus utilisée.
Modélisez le produit, pas l’écran
C’est peut-être la règle la plus importante. Une table doit représenter un véritable concept du produit, et non simplement un écran de l’interface. La conception d’un tableau de bord peut changer complètement. Un client, une réservation ou une commande représente toujours la même entité. Réfléchir d’abord au modèle de données facilite également l’évolution future du frontend.
SQL, Postgres et Supabase : ce qu’il faut vraiment retenir
Si vous débutez, vous n’avez pas besoin de mémoriser des dizaines de termes.
Retenez simplement cette relation :
SQL → le langage utilisé pour interroger et modifier les données Postgres → la base de données relationnelle qui stocke les données et exécute les requêtes Supabase → la plateforme backend qui utilise Postgres et ajoute l’authentification, le stockage, les API, les fonctions et les outils nécessaires à la création d’applications web
Dans Coderblock, ces concepts sont intégrés au processus de création d’applications. Vous pouvez décrire en langage naturel ce que votre application doit mémoriser, comment les données doivent être reliées et qui peut y accéder. L’agent peut prendre en charge l’implémentation full-stack pendant que vous examinez et affinez le résultat dans le chat.
Comprendre le fonctionnement des bases de données vous aide donc à accomplir quelque chose d’encore plus important : décrire plus clairement ce que vous souhaitez créer. Vous n’avez pas nécessairement besoin d’écrire du SQL. Mais comprendre ce que sont les tables, les relations, les rôles, les contraintes et les autorisations vous aidera à transformer une idée en une application qui ne se contente pas d’afficher des données : elle peut réellement les stocker, les relier et les protéger.