Les API REST expliquées aux non-développeurs
Une API REST est un système structuré qui permet aux applications et aux services d’échanger des informations sur le web. Découvrez le fonctionnement des requêtes, des réponses, des endpoints, de l’authentification et des erreurs, ainsi que les points à prendre en compte pour concevoir des fonctionnalités reposant sur des API.
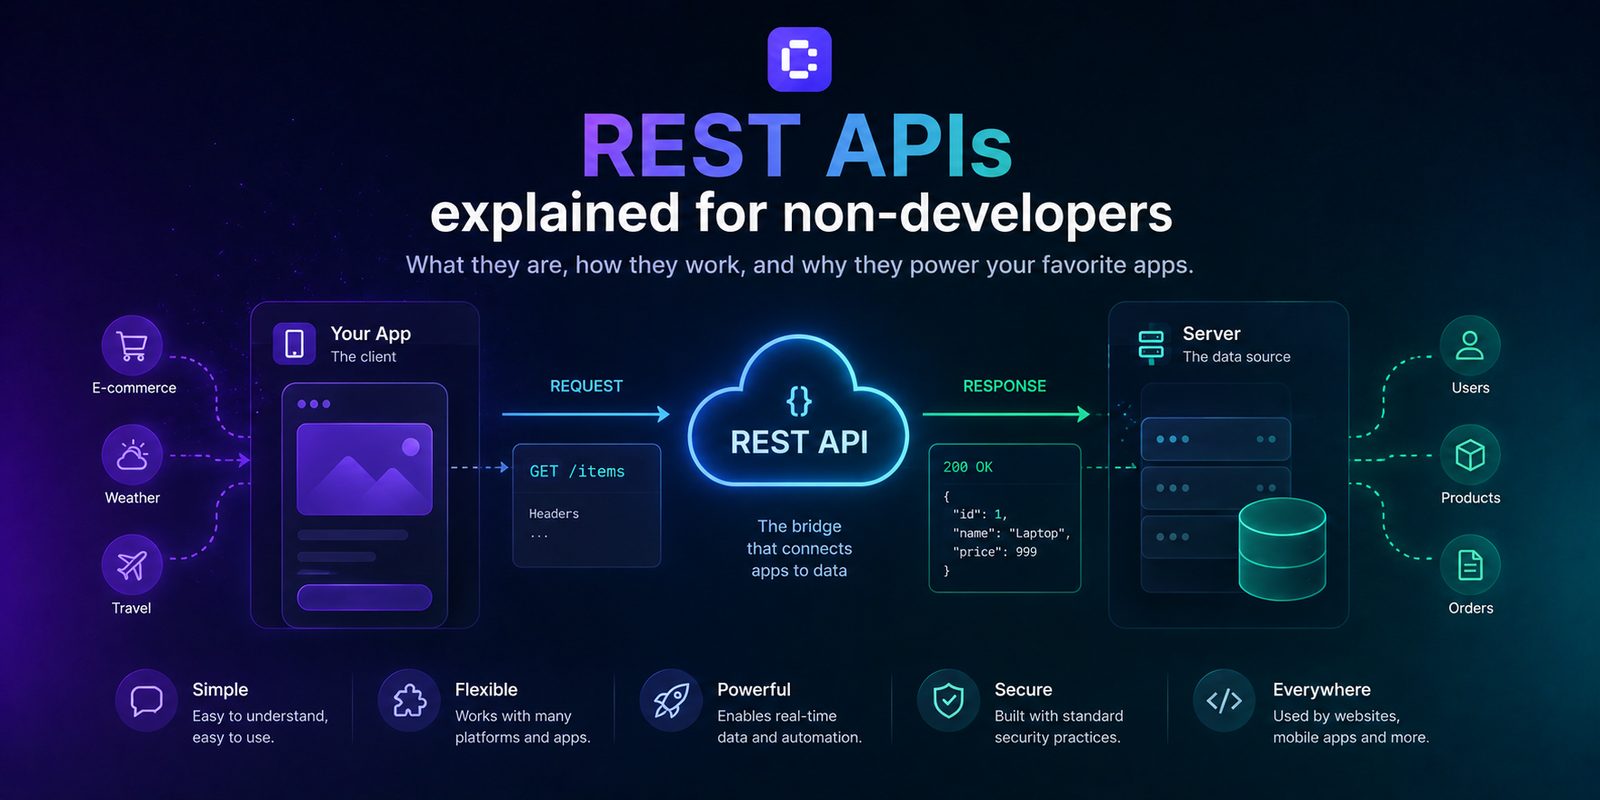
Qu’est-ce qu’une API REST ?
 Lorsque vous utilisez une application, une grande partie des informations affichées à l’écran provient de services externes.
La météo à votre destination, le statut d’une livraison, le prix d’un produit, une réservation ou le résultat d’un paiement : bien souvent, l’application ne gère pas directement toutes ces données. Elle les demande à d’autres systèmes.
C’est là qu’interviennent les API. Une API permet à deux systèmes logiciels de communiquer selon un ensemble de règles définies. Une API REST est l’un des moyens les plus courants d’établir cette communication sur le web. Vous pouvez l’imaginer comme une conversation structurée entre des applications :
« Donne-moi les informations sur ce produit. »
Le service répond :
« Voici son nom, son prix et sa disponibilité. »
Ou encore :
« Crée une nouvelle réservation pour ce client. »
Et le service peut répondre :
« Réservation créée. »
REST signifie Representational State Transfer. Il n’est pas nécessaire de retenir cet acronyme pour comprendre son fonctionnement. L’idée principale est plus simple : une API REST organise les données sous forme de ressources — par exemple des utilisateurs, des produits, des commandes ou des réservations — et définit une méthode standard pour les consulter, les créer, les modifier ou les supprimer.
Un exemple concret
Imaginez une application de voyage qui affiche la météo de la destination où vous vous apprêtez à partir. L’application n’a pas nécessairement besoin de collecter et de mettre à jour elle-même toutes les données météorologiques. Elle peut envoyer une requête à l’API d’un service météo.
Le flux ressemble à ceci :
Votre application → requête API → service météo → réponse → votre application
La réponse peut contenir la température, les conditions météorologiques et les prévisions des prochains jours. L’utilisateur voit simplement la météo. Mais derrière cet écran, deux systèmes communiquent entre eux.
L’analogie du restaurant
Une façon simple de comprendre une API consiste à imaginer que vous êtes au restaurant.
- Vous représentez l’application qui souhaite obtenir quelque chose.
- Le menu décrit ce que vous pouvez demander.
- Le serveur transmet la demande et vous apporte la réponse.
- La cuisine représente le service qui effectue le travail.
L’API joue à la fois le rôle du menu et du serveur. Elle indique ce que vous pouvez demander, comment formuler votre requête et quel type de réponse vous pouvez attendre. Vous n’avez pas besoin de savoir comment fonctionne la cuisine pour commander un plat. De même, une application n’a pas nécessairement besoin de connaître le fonctionnement interne d’un service pour utiliser son API.
Comment fonctionne une requête d’API REST ?
Chaque requête API contient quelques informations essentielles.
Endpoint : où envoyer la requête
L’endpoint, ou point d’accès, est l’adresse à laquelle la requête est envoyée. Par exemple :
https://api.example.com/products/42
Cette adresse peut représenter le produit dont l’identifiant est 42. Différents endpoints peuvent représenter un ensemble de ressources, un élément précis ou une opération particulière.
Méthode HTTP : ce que vous voulez faire
La méthode HTTP indique au service l’opération que vous souhaitez effectuer. Les méthodes les plus courantes sont :
- GET → récupérer des informations ;
- POST → créer une nouvelle ressource ;
- PUT ou PATCH → mettre à jour une ressource existante ;
- DELETE → supprimer une ressource.
Par exemple, sur une plateforme de réservation :
GET /bookings
peut servir à récupérer les réservations, tandis que :
POST /bookings
peut permettre d’en créer une nouvelle. Il s’agit de conventions largement utilisées, mais elles ne constituent pas une garantie absolue. La documentation de l’API reste toujours la référence.
En-têtes et corps : les informations complémentaires
Les en-têtes contiennent des informations utiles à la requête, comme le format des données ou les identifiants utilisés pour l’authentification. Le corps contient quant à lui les données nécessaires à l’exécution de l’opération. Par exemple, si vous souhaitez créer une réservation, le corps peut contenir :
{
  "service": "Consultation",
  "date": "2026-09-15",
  "time": "14:00"
}
Ces données sont souvent représentées en JSON, un format très répandu parce qu’il est structuré et facile à lire aussi bien pour les humains que pour les logiciels.
Que se passe-t-il lorsque la réponse arrive ?
Après avoir reçu la requête, le service la traite et renvoie une réponse. Cette réponse contient généralement les données demandées ou le résultat de l’opération, ainsi qu’un code de statut HTTP indiquant ce qui s’est passé. Les codes les plus courants se répartissent en trois grandes catégories.
200–299 : tout s’est bien passé
La requête a été traitée avec succès. Par exemple :
200 OK→ requête effectuée ;201 Created→ nouvelle ressource créée.
400–499 : la requête présente un problème
Le problème concerne généralement la requête elle-même ou les autorisations du client. Par exemple :
400 Bad Request→ données non valides ;401 Unauthorized→ authentification absente ou non valide ;403 Forbidden→ l’utilisateur ne dispose pas des autorisations requises ;404 Not Found→ la ressource demandée n’existe pas.
500–599 : problème côté serveur
Le service chargé de traiter la requête a rencontré un problème.
Pour les utilisateurs, cependant, un code comme 409 ou 500 n’est pas très parlant.
Une bonne application transforme donc l’erreur technique en un message clair :
« Ce créneau n’est plus disponible. Choisissez un autre horaire. »
est bien plus utile que :
« HTTP 409 Conflict. »
API REST, bases de données, webhooks et GraphQL : quelle différence ?
Ces technologies et concepts sont liés, mais ils répondent à des besoins différents.
API REST et bases de données
Une base de données stocke des informations. Une API, quant à elle, définit la manière dont d’autres systèmes peuvent interagir avec ces informations. Par exemple, une base de données peut contenir :
- des utilisateurs ;
- des produits ;
- des commandes ;
- des réservations.
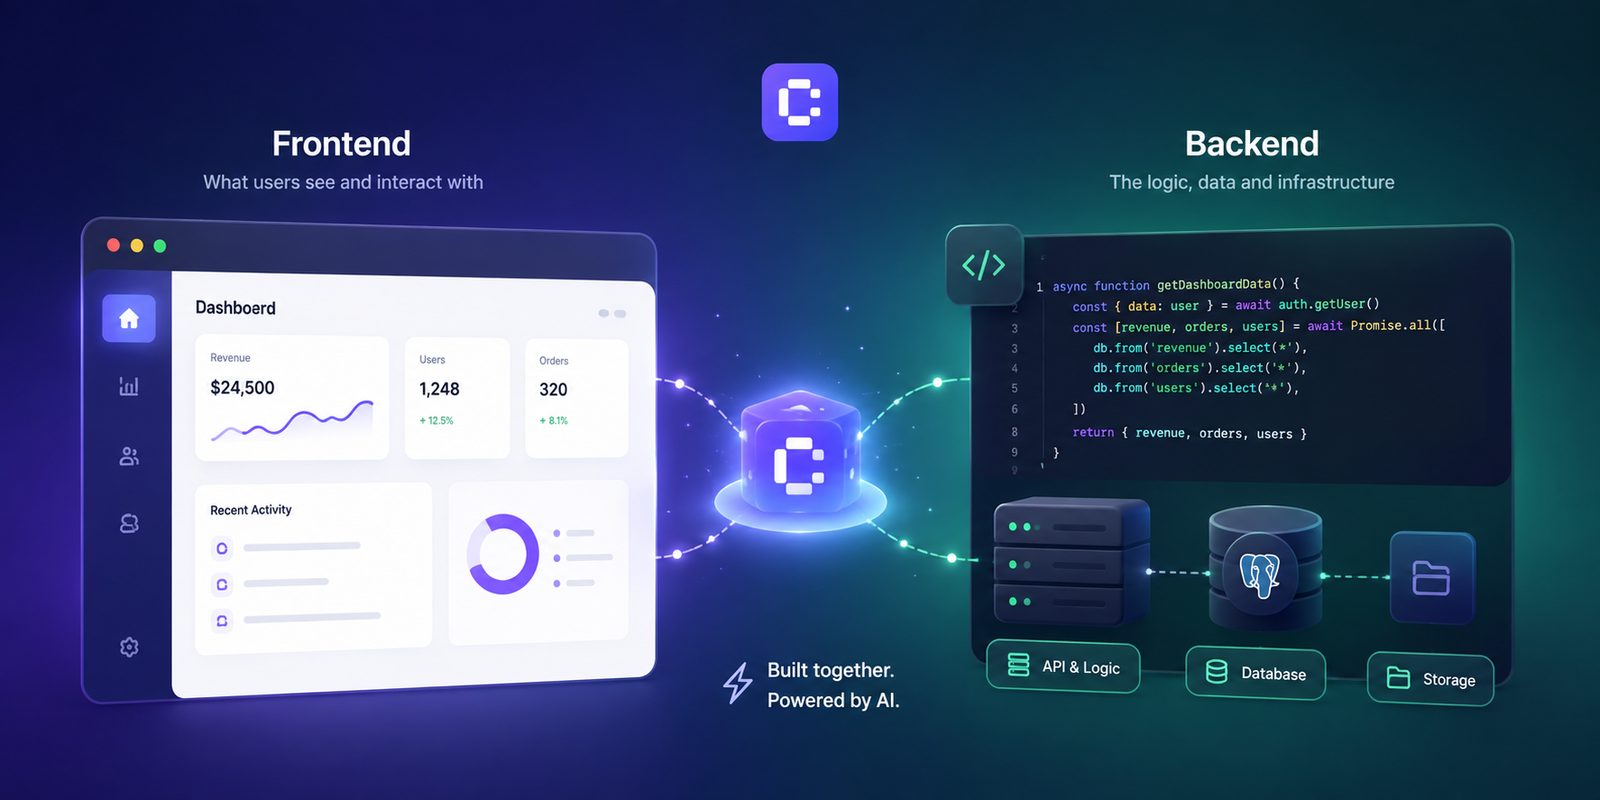
L’API peut déterminer quelles données peuvent être consultées, créées ou modifiées — et par qui. Elle ajoute ainsi une couche de contrôle entre l’application et les données. Connecter directement un navigateur à une base de données sans protections suffisantes pourrait exposer des informations ou des opérations qui devraient rester privées. Dans Coderblock, l’agent peut concevoir et appliquer un schéma de base de données Postgres au fil de la conversation. Les applications web standard utilisent un projet Supabase dédié avec Postgres, Auth, Storage et Row Level Security. La section Backend vous permet également de consulter les tables, les utilisateurs authentifiés, le stockage et les fonctions.
API REST et webhooks
Les API et les webhooks fonctionnent dans des directions différentes. Avec une requête API standard, votre application demande une information :
« Le paiement a-t-il été effectué ? »
Avec un webhook, un autre service informe spontanément votre application qu’un événement vient de se produire :
« Le paiement vient d’être effectué avec succès. »
Les webhooks sont particulièrement utiles pour les événements qui se produisent plus tard, comme les paiements, les mises à jour de livraison ou les changements de statut d’une commande. Ils doivent toutefois être vérifiés et traités de manière sécurisée. Dans le processus Stripe géré par Coderblock, la plateforme peut prendre en charge la configuration des webhooks. En mode BYOK, l’agent demande de manière sécurisée la clé secrète Stripe et configure automatiquement le webhook.
REST et GraphQL
REST et GraphQL sont deux approches différentes de la communication entre applications. Avec REST, vous travaillez généralement avec plusieurs endpoints représentant différentes ressources. GraphQL utilise plutôt une interface de requête grâce à laquelle le client peut préciser exactement les données qu’il souhaite recevoir. GraphQL peut être particulièrement utile lorsque les besoins en données sont complexes et que le client doit mieux contrôler la réponse. REST, de son côté, est très répandu et souvent plus facile à comprendre. Aucune de ces approches n’est cependant meilleure dans tous les cas. Le bon choix dépend de l’architecture du service, des besoins du produit, de l’équipe et du type de client qui l’utilisera.
Authentification et autorisation ne désignent pas la même chose
Deux concepts sont souvent confondus : l’authentification et l’autorisation. La différence est simple. Authentification :
« Qui êtes-vous ? »
Autorisation :
« Qu’avez-vous le droit de faire ? »
Imaginez une plateforme utilisée par des clients et des administrateurs. La connexion permet de vérifier que vous êtes bien un utilisateur précis. Mais cela ne signifie pas automatiquement que vous pouvez consulter toutes les données de l’application. Un client peut être autorisé à voir ses propres réservations. Un administrateur peut être autorisé à voir les réservations de tous les clients. Le type d’identité sous-jacent est le même, mais les autorisations sont différentes.
Qu’en est-il des clés API ?
Une clé API sert souvent à identifier l’application ou le service qui envoie une requête. Une session authentifiée peut, quant à elle, identifier l’utilisateur connecté. Aucune des deux ne doit être considérée comme un laissez-passer universel.
Les autorisations doivent être définies séparément et également appliquées côté serveur ou dans la base de données. Dans Coderblock, vous pouvez demander directement dans le chat :
« Ajoute la connexion et les comptes utilisateurs. »
L’agent peut configurer Supabase Auth, les pages d’inscription et de connexion, la gestion des sessions, les routes protégées et la Row Level Security associée à l’utilisateur authentifié. Les applications incluent également une structure de base pour les profils et les rôles. Vous n’avez donc pas besoin de créer manuellement une table de mots de passe ni de développer toute la logique d’authentification à partir de zéro.
Où stocker les clés API ?
Les identifiants privés constituent un autre point essentiel. Une clé API secrète ne doit jamais être placée dans le frontend, publiée sur GitHub ou stockée dans un champ accessible aux utilisateurs. Lorsqu’un projet Coderblock nécessite un secret, l’agent peut le recueillir au moyen d’une demande sécurisée de variables d’environnement. La valeur est stockée dans l’espace de secrets côté serveur du projet et n’est ajoutée ni au code du frontend ni à la conversation.
Comment concevoir une fonctionnalité utilisant une API
Lorsque vous créez une application avec un outil de développement assisté par l’IA, vous n’avez pas besoin de commencer par la technologie. Commencez par le résultat attendu pour l’utilisateur. « Afficher aux clients le statut de livraison de leur commande » est plus utile que :
« Ajoute une API. »
Vous pouvez ensuite définir les éléments nécessaires.
1. Identifier la source des données
Quel système contient les bonnes informations ? Votre base de données ? Un service externe ? Stripe ? Un système de gestion des livraisons ? Il doit exister une source de vérité clairement définie.
2. Consulter la documentation
Avant d’intégrer un service, vérifiez :
- les endpoints disponibles ;
- les méthodes d’authentification ;
- les environnements de test ;
- les limites d’utilisation ;
- les formats des requêtes et des réponses ;
- la prise en charge éventuelle des webhooks.
3. Anticiper les erreurs
Que se passe-t-il si le service externe est lent ? S’il est temporairement indisponible ? S’il renvoie des données incomplètes ? Une application bien conçue doit prévoir un comportement précis même lorsqu’une API ne répond pas comme prévu.
4. Valider les données entrantes et sortantes
Ne partez pas du principe que toutes les informations reçues d’un service externe sont toujours correctes. Les données doivent être validées avant d’être utilisées ou enregistrées.
5. Limiter les autorisations
Une intégration ne doit disposer que des accès dont elle a réellement besoin. Si un service doit pouvoir consulter des paiements, cela ne signifie pas nécessairement qu’il doit aussi pouvoir les modifier.
6. Protéger les secrets
Les identifiants privés doivent rester côté serveur. Le navigateur ne doit jamais recevoir une clé API permettant d’effectuer des opérations restreintes.
7. Tester avant la mise en production
Dans la mesure du possible, utilisez l’environnement de test du service. Ne testez pas seulement les opérations réussies, mais aussi les requêtes refusées, les erreurs, les délais d’expiration, les doublons et les annulations.
8. Éviter les requêtes inutiles
Toutes les informations n’ont pas besoin d’être redemandées à chaque chargement de page. Lorsque les données le permettent, la mise en cache peut réduire les temps de réponse, le nombre de requêtes et les coûts d’intégration.
Utiliser des API dans Coderblock
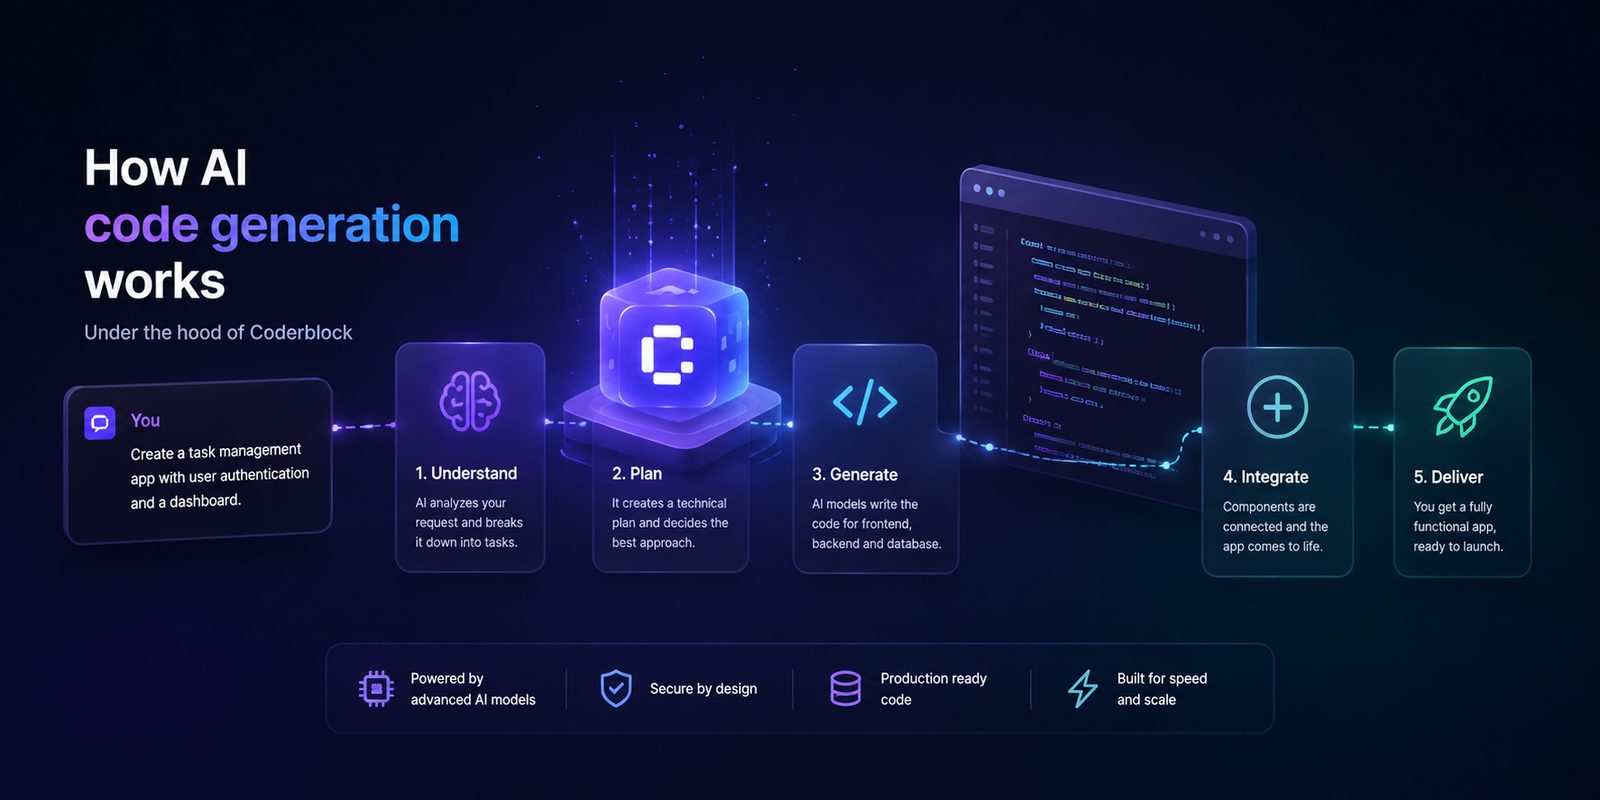
Avec Coderblock, les API s’intègrent au même processus conversationnel que celui utilisé pour créer le reste de l’application. Vous pouvez partir d’une idée ou d’un modèle de produit et demander à l’IA de créer le frontend, le backend et la base de données.
Lorsque vous souhaitez ajouter une intégration, il est utile de décrire le comportement attendu. Par exemple :
« Ajoute un accès par compte. Chaque client ne doit pouvoir consulter que ses propres réservations. Si le service de planification externe est indisponible, affiche un message clair et permets à l’utilisateur de réessayer. »
Une demande de ce type indique non seulement quelle technologie utiliser, mais surtout ce qui doit se passer dans l’application.
L’agent peut prendre en charge l’implémentation technique pendant que vous vérifiez le résultat dans l’aperçu en direct sur coderblock.dev et continuez à l’améliorer dans le chat.
Pourquoi comprendre les API est utile, même sans savoir coder
Vous n’avez pas besoin d’être développeur pour comprendre le principe d’une API REST. Mais en connaître les bases change votre manière de concevoir une application. Cela vous aide à comprendre pourquoi une intégration Stripe est différente d’une connexion à une base de données, pourquoi un webhook est différent d’une requête API standard et pourquoi une clé API ne doit jamais être exposée dans le frontend. Surtout, cela vous aide à rédiger de meilleurs prompts pour l’IA.
Au lieu de demander simplement :
« Ajoute une API. »
vous pouvez décrire ce qui doit se passer, les données à utiliser, les personnes autorisées à y accéder et le comportement attendu en cas de problème. L’IA peut gérer une grande partie de la complexité technique.
Mais plus vous décrivez clairement le comportement souhaité, plus vous gardez le contrôle sur le produit que vous créez.