Datenbanken für Einsteiger: SQL, Postgres und Supabase erklärt
Erfahre, wie relationale Datenbanken Informationen organisieren, wie SQL funktioniert und warum Postgres und Supabase in modernen Web-Apps häufig gemeinsam eingesetzt werden. Diese Lektion behandelt außerdem Schemadesign, Sicherheit und praktische Datenbank-Workflows in Coderblock.
Warum Web-Apps Datenbanken brauchen
Eine Anwendung kann eine Oberfläche anzeigen, Informationen erfassen oder eine Aktion ausführen. Aber was passiert, wenn sie sich etwas merken muss?
Eine Buchungsplattform muss sich Kunden, Dienstleistungen und Termine merken. Ein Onlineshop muss Produkte, Bestellungen und Lagerbestände verwalten. Eine SaaS-Plattform muss wissen, welche Benutzer ein Konto haben, welche Projekte sie erstellt haben und über welche Berechtigungen sie verfügen.
Deshalb gibt es Datenbanken.
In einer Datenbank speichert eine Anwendung die benötigten Informationen strukturiert und dauerhaft. Ohne Datenbank wären viele dieser Daten möglicherweise nur vorübergehend im Browser vorhanden. Sobald die Seite geschlossen wird, könnten sie verloren gehen. Mit einer Datenbank kann die App Informationen speichern und später wieder abrufen – auf unterschiedlichen Geräten und für verschiedene Benutzer.
Eine Datenbank ist das Gedächtnis der App
Du kannst dir eine Datenbank als das Langzeitgedächtnis einer Anwendung vorstellen.
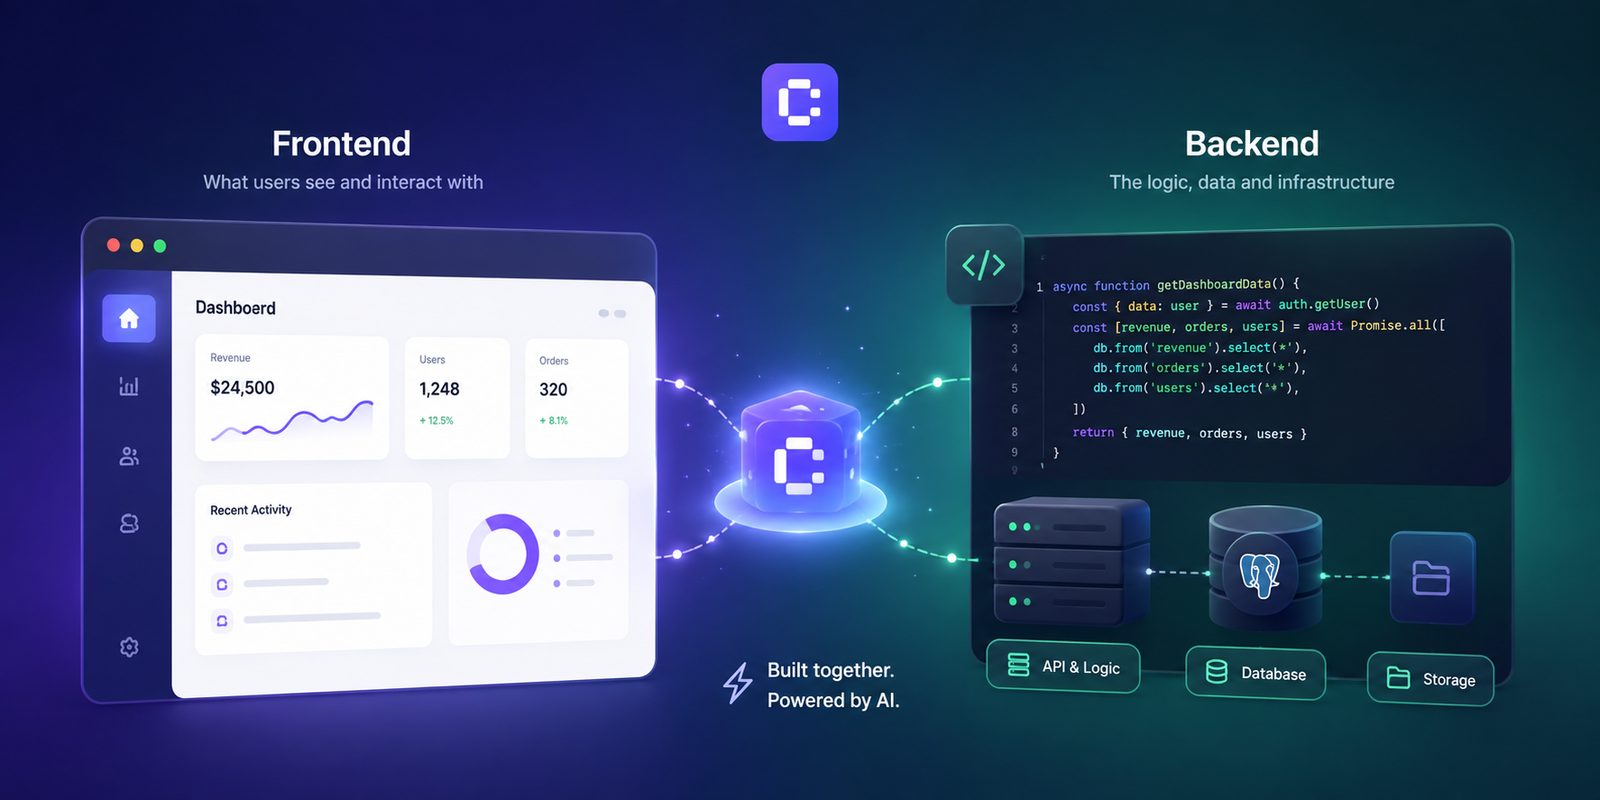
Das Frontend zeigt Informationen an. Das Backend setzt die Logik um. Die Datenbank speichert die Daten.
In einer Buchungs-App bedeutet das zum Beispiel:
Frontend → zeigt Dienstleistungen und den Kalender an Backend → prüft Verfügbarkeit und Berechtigungen Datenbank → speichert Benutzer, Dienstleistungen und Buchungen
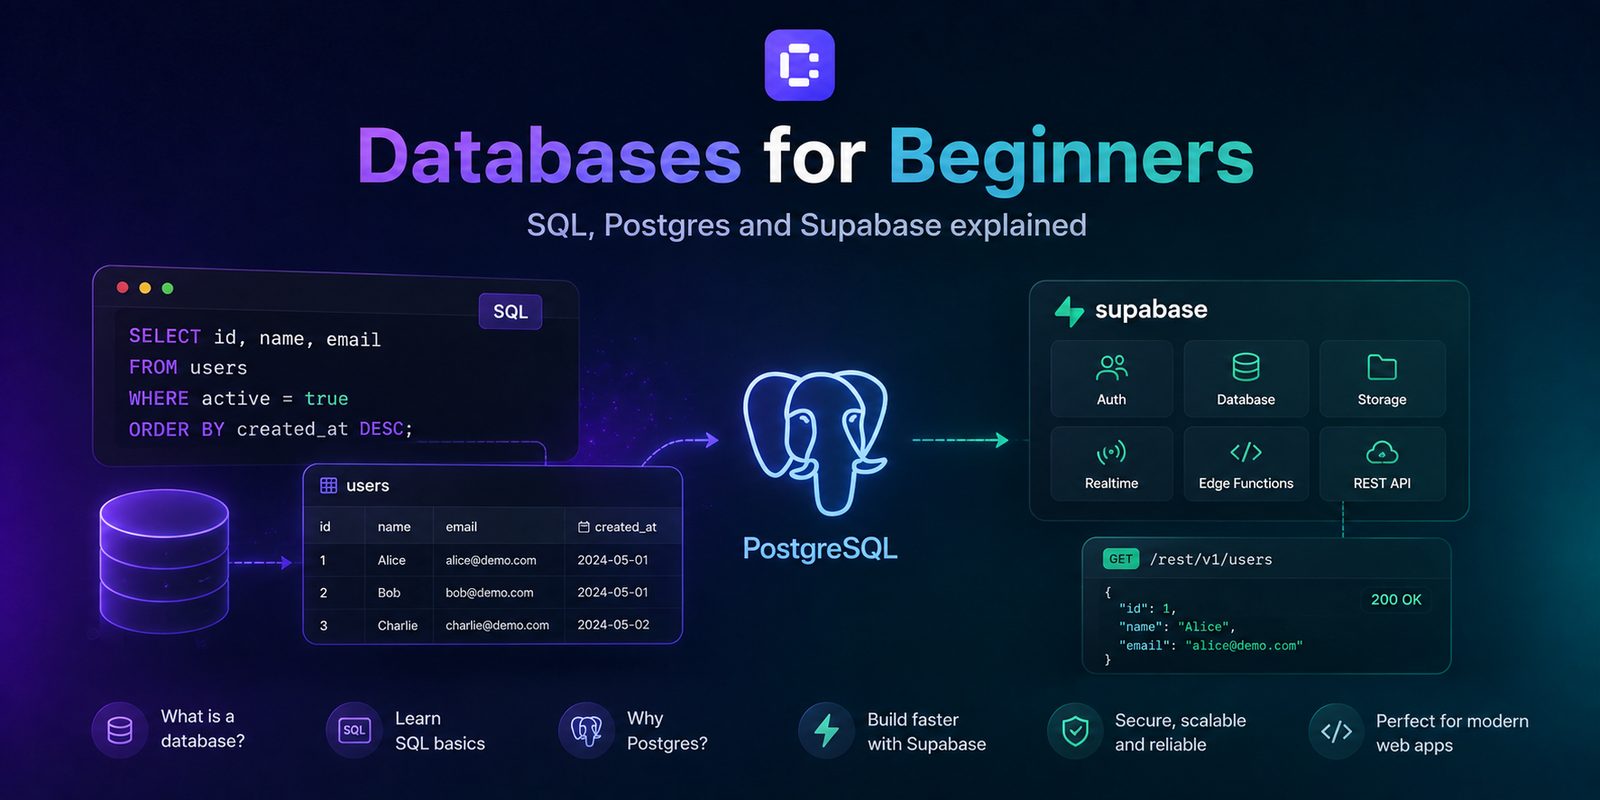
Es gibt verschiedene Arten von Datenbanken. Dokumentendatenbanken arbeiten mit flexiblen Dokumenten, Key-Value-Datenbanken sind für bestimmte Arten schneller Zugriffe optimiert, während relationale Datenbanken Daten in miteinander verknüpften Tabellen organisieren. SQL und Postgres gehören hauptsächlich in diese Welt. Supabase wiederum stellt rund um Postgres eine Sammlung von Backend-Diensten für Webanwendungen bereit.
Relationale Datenbanken: Tabellen, Zeilen und Beziehungen
Eine relationale Datenbank organisiert Informationen in Tabellen. Jede Tabelle repräsentiert in der Regel einen bestimmten Entitätstyp. Auf einer Buchungsplattform könnte es beispielsweise folgende Tabellen geben:
profiles→ Benutzer;services→ verfügbare Dienstleistungen;bookings→ Buchungen.
In jeder Tabelle findest du:
- Spalten, die die Eigenschaften der Daten beschreiben;
- Zeilen, die einzelne Datensätze darstellen;
- Primärschlüssel, die jeden Datensatz eindeutig identifizieren;
- Fremdschlüssel, die Datensätze aus verschiedenen Tabellen miteinander verbinden;
- Constraints, die verhindern, dass ungültige Daten gespeichert werden.
Eine Buchung könnte beispielsweise eine profile_id und eine service_id enthalten.
So lässt sich eindeutig erkennen, wer die Buchung vorgenommen und welche Dienstleistung diese Person ausgewählt hat, ohne sämtliche Benutzer- und Dienstleistungsdaten in jede einzelne Buchung kopieren zu müssen.
Warum sind Beziehungen wichtig?
Stell dir vor, eine Dienstleistung wird umbenannt. Wäre ihr Name in jede Buchung kopiert worden, müsstest du Hunderte oder Tausende Datensätze aktualisieren. In einer relationalen Datenbank kann die Buchung stattdessen einfach auf die richtige Dienstleistung verweisen. Beziehungen zwischen Daten helfen daher, Duplikate und Inkonsistenzen zu reduzieren und gleichzeitig das Produktmodell übersichtlich zu halten.
Was ist ein Datenbankschema?
Bevor du eine Datenbank erstellst, musst du entscheiden, wie die Informationen organisiert werden sollen. Die Gesamtheit aus Tabellen, Spalten, Beziehungen, Datentypen und Constraints, die diese Struktur definiert, wird als Schema bezeichnet. Ein gutes Schemadesign sorgt dafür, dass die Datenbank die tatsächliche Funktionsweise des Produkts widerspiegelt.
Bevor du eine neue Tabelle erstellst, solltest du dir folgende Fragen stellen:
- Was stellt jeder Datensatz dar?
- Welche Informationen sind erforderlich?
- Welche Werte müssen eindeutig sein?
- Welche Entitäten müssen miteinander verbunden werden?
- Wer darf diese Daten lesen oder ändern?
Das Ziel besteht nicht darin, möglichst viele Tabellen zu erstellen. Eine einzige riesige Tabelle mit völlig unterschiedlichen Arten von Informationen kann schwer zu verwalten sein. Gleichzeitig kann es das System unnötig kompliziert machen, wenn jedes noch so kleine Datenelement in einer eigenen Tabelle abgelegt wird.
Ein gutes Schema schafft ein Gleichgewicht zwischen Datenkonsistenz, einfachen Abfragen und den tatsächlichen Anforderungen des Produkts.
Was ist SQL?
Hier kommt SQL ins Spiel, die Abkürzung für Structured Query Language. SQL ist die Sprache, mit der viele relationale Datenbanken gesteuert und abgefragt werden.
Du kannst damit:
- Strukturen erstellen;
- Daten lesen;
- Datensätze hinzufügen;
- Informationen ändern;
- Datensätze löschen;
- Daten aus verschiedenen Tabellen miteinander verknüpfen.
Die vier grundlegenden Operationen werden häufig unter dem Akronym CRUD zusammengefasst:
- Create → erstellen
- Read → lesen
- Update → aktualisieren
- Delete → löschen
Ein einfaches Beispiel
Angenommen, wir möchten die Buchungen eines bestimmten Benutzers abrufen. Eine SQL-Abfrage könnte so aussehen:
SELECT id, start_time, status
FROM bookings
WHERE profile_id = 42
ORDER BY start_time;
Vereinfacht ausgedrückt sagen wir damit:
„Gib mir die IDs, Zeiten und Statuswerte der Buchungen von Benutzer 42, sortiert nach Zeit.“
SQL kann auch Informationen aus verschiedenen Tabellen zusammenführen. Zum Beispiel:
SELECT bookings.start_time, services.name
FROM bookings
JOIN services ON services.id = bookings.service_id;
Diese Abfrage verknüpft Buchungen mit den zugehörigen Dienstleistungen, sodass neben der Buchungszeit auch der Name der Dienstleistung zurückgegeben wird.
SQL ist deklarativ
Eine wichtige Eigenschaft von SQL ist, dass es sich um eine deklarative Sprache handelt. Du musst nicht unbedingt jeden einzelnen Schritt angeben, den die Datenbank ausführen soll, um eine Information zu finden. Du beschreibst, welches Ergebnis du möchtest, und die Datenbank entscheidet, wie sie die Abfrage ausführt.
SQL ist außerdem ein weitverbreiteter Standard, auch wenn verschiedene Systeme eigene Funktionen und Erweiterungen anbieten können. Du musst nicht alles auf einmal lernen. Wenn du Konzepte wie SELECT, Filter, JOINs, Gruppierungen, Constraints und Transaktionen verstehst, verfügst du bereits über eine solide Grundlage.
Was ist Postgres?
Hier ist eine wichtige Unterscheidung nötig: SQL ist die Sprache. Postgres ist die Datenbank.
Postgres, genauer gesagt PostgreSQL, ist ein relationales Open-Source-Datenbankmanagementsystem. Es ist die Software, die Daten speichert, Constraints durchsetzt und SQL-Abfragen interpretiert.
Du kannst dir die Beziehung so vorstellen:
SQL → die Sprache, mit der du kommunizierst Postgres → das System, das die Daten speichert und verwaltet
Postgres unterstützt wichtige Funktionen wie:
- Primär- und Fremdschlüssel
- Transaktionen
- Indizes
- Views
- Constraints
- fortgeschrittene Datentypen
Warum sind Transaktionen wichtig?
Stell dir einen Onlineshop vor. Wenn ein Kunde ein Produkt kauft, muss das System möglicherweise:
- die Bestellung erstellen;
- den Lagerbestand reduzieren;
- die Zahlung erfassen.
Diese Vorgänge hängen miteinander zusammen. Wenn der erste erfolgreich ist, der zweite jedoch fehlschlägt, könnte eine Bestellung erfasst sein, obwohl der Lagerbestand nie aktualisiert wurde.
Mit Transaktionen kannst du mehrere Vorgänge als eine Einheit behandeln: Entweder werden alle erfolgreich abgeschlossen oder die Datenbank stellt den vorherigen Zustand wieder her.
Was ist mit Indizes?
Indizes beschleunigen bestimmte Suchvorgänge. Wenn eine Anwendung wiederholt die Buchungen eines Benutzers an einem bestimmten Datum finden muss, kann ein Index diesen Vorgang deutlich effizienter machen. Indizes sind jedoch nicht kostenlos: Sie belegen Speicherplatz und verursachen bei jeder Datenänderung zusätzlichen Aufwand.
Deshalb ist es keine Best Practice, automatisch jede Spalte zu indexieren. Ein Index sollte ein tatsächliches Abfragemuster im Produkt unterstützen.
Was ist Supabase?
Wenn Postgres die Datenbank ist, dann ist Supabase eine auf Postgres aufbauende Backend-Plattform. Supabase ersetzt Postgres nicht.
Stattdessen ergänzt es eine Reihe von Diensten, die häufig für die Entwicklung von Webanwendungen benötigt werden, darunter:
- Authentifizierung und Sitzungsverwaltung;
- Dateispeicher;
- Werkzeuge zur Datenbankverwaltung;
- serverseitige Funktionen;
- Daten-APIs;
- Row Level Security.
Die wichtigste Unterscheidung lautet:
SQL ist die Sprache. Postgres ist die Datenbank. Supabase ist eine Backend-Plattform, die Postgres verwendet und zusätzliche Dienste für die Anwendungsentwicklung bereitstellt.
Diese Kombination ist besonders für Web-Apps geeignet, weil sich Daten, Benutzer, Dateien und Berechtigungen innerhalb einer integrierten Infrastruktur verwalten lassen.
Authentifizierung und Autorisierung: zwei verschiedene Dinge
Auch hier ist es hilfreich, zwei Konzepte voneinander zu trennen. Authentifizierung beantwortet die Frage:
„Wer ist dieser Benutzer?“
Autorisierung beantwortet die Frage:
„Was darf dieser Benutzer tun?“
Supabase Auth kann Registrierung, Anmeldung und Sitzungen verwalten. Row Level Security (RLS) kann festlegen, welche Datenbankzeilen ein bestimmter Benutzer lesen oder ändern darf. Stell dir eine Buchungsplattform vor. Ein Kunde sollte Folgendes sehen können:
seine eigenen Buchungen.
Ein Administrator hingegen darf möglicherweise Folgendes sehen:
alle Buchungen.
Beide sind authentifizierte Benutzer, verfügen aber über unterschiedliche Berechtigungen.
Sicherheit darf nicht allein vom Frontend abhängen
Eine ausgeblendete Schaltfläche in der Benutzeroberfläche verhindert nicht, dass jemand einen Vorgang ausführt. Ein Benutzer könnte versuchen, eine Anfrage direkt an das Backend zu senden.
Deshalb müssen Zugriffsregeln im Backend und in der Datenbank durchgesetzt werden, nicht nur in der Benutzeroberfläche. Hier wird Row Level Security wichtig: Damit kannst du Zugriffsregeln direkt auf Datenbankebene definieren.
Wie Datenbanken in Coderblock funktionieren
In standardmäßigen Coderblock-Web-Apps verfügt jedes Projekt über eine eigene Supabase-Umgebung mit Postgres, Auth, Storage, Deno Edge Functions und Row Level Security. Eine grundlegende Profilstruktur und ein anfängliches Rollensystem sind ebenfalls standardmäßig enthalten.
Der Unterschied besteht darin, dass du nicht unbedingt mit der manuellen Konfiguration der Datenbank beginnen musst. Du kannst im Chat beschreiben, was du entwickeln möchtest.
Zum Beispiel:
„Füge Dienstleistungen mit Dauer, Preis und Aktivstatus hinzu.“
Dann:
„Erstelle Buchungen, die mit authentifizierten Benutzern verknüpft sind.“
Und anschließend:
„Verhindere, dass Kunden die Buchungen anderer Kunden sehen, und erstelle eine Admin-Ansicht zur Verwaltung aller Buchungen.“
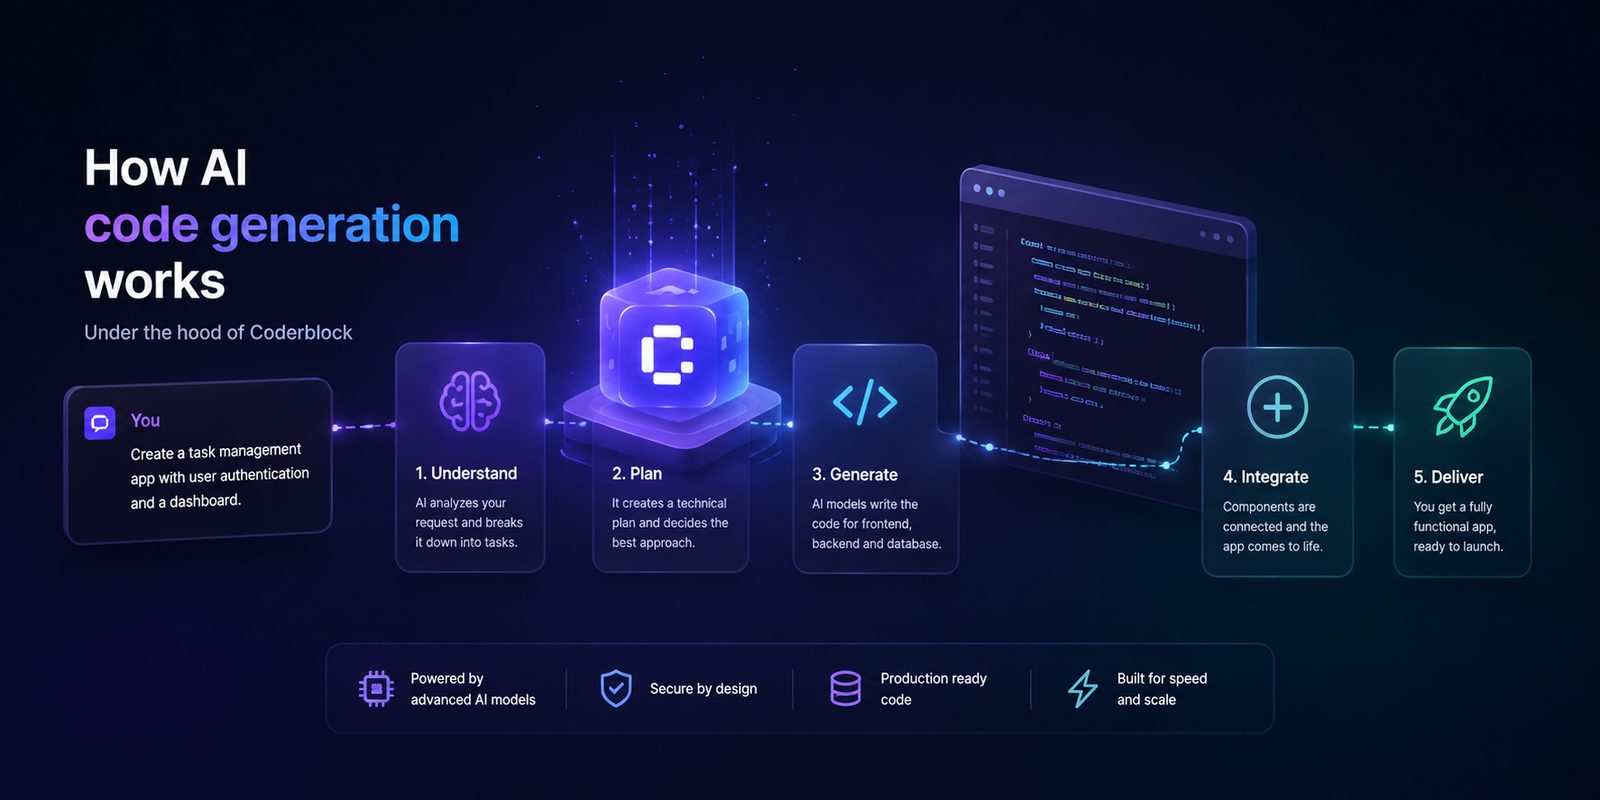
Der Agent kann das Schema entwerfen, Migrationen anwenden, das React-Frontend mit dem Backend verbinden und die erforderlichen RLS-Richtlinien konfigurieren. Im Bereich Backend des Editors kannst du anschließend Tabellen, authentifizierte Benutzer, Speicher und Funktionen einsehen.
Die Live-Vorschau wird aktualisiert, während du die App im Gespräch weiter bearbeitest.
Der beste Prompt lautet nicht „Erstelle eine Datenbank“
Wenn du mit einem KI-App-Builder arbeitest, reicht folgende Aufforderung nicht aus:
„Erstelle eine Datenbank für eine Buchungs-App.“
Viel hilfreicher ist es, das Produktmodell zu beschreiben. Gib Folgendes an:
- die wichtigsten Entitäten;
- welche Informationen sie enthalten sollen;
- wie sie miteinander verbunden sind;
- welche Felder erforderlich sind;
- welche Benutzer auf die Daten zugreifen dürfen;
- welche Aktionen sie ausführen dürfen.
So erhält die KI die Informationen, die sie benötigt, um eine Produktbeschreibung in eine konsistente Datenstruktur zu überführen.
Datenbank-Best-Practices für Einsteiger
Du musst kein Datenbankentwickler sein, um die häufigsten Fehler zu vermeiden.
Verwende stabile Bezeichner
Jede wichtige Tabelle sollte einen Primärschlüssel besitzen. Verwende Daten wie Namen oder E-Mail-Adressen nicht als dauerhafte Bezeichner, da sie sich ändern können.
Halte Regeln nah an den Daten
Die Validierung im Frontend ist für die Benutzererfahrung hilfreich, sollte aber nicht die einzige Schutzmaßnahme sein. Verwende:
- Pflichtfelder;
- Unique Constraints;
- Fremdschlüssel;
- geeignete Datentypen;
- Zugriffsrichtlinien.
So kann die Datenbank die Datenintegrität schützen, unabhängig davon, woher eine Anfrage stammt.
Befolge das Prinzip der geringsten Rechte
Jeder Benutzer sollte nur über die Berechtigungen verfügen, die er für seine Aufgaben benötigt. Teste die App mit verschiedenen Rollen:
- anonymer Besucher;
- authentifizierter Benutzer;
- Administrator.
Überprüfe immer, was jede Rolle lesen, erstellen, ändern oder löschen darf.
Verwalte das Schema über Migrationen
Datenbanken verändern sich gemeinsam mit Produkten. Wenn du eine neue Funktion hinzufügst, musst du möglicherweise eine Tabelle erstellen, eine Spalte hinzufügen oder eine Beziehung ändern. Mit kontrollierten Migrationen kannst du diese Änderungen nachvollziehen und das Risiko verringern, bestehende Daten zu verlieren. Bevor du eine Spalte löschst oder eine Struktur änderst, solltest du immer sicherstellen, dass sie nicht mehr verwendet wird.
Modelliere das Produkt, nicht die Oberfläche
Das ist möglicherweise die wichtigste Regel. Eine Tabelle sollte ein echtes Produktkonzept darstellen und nicht einfach eine Ansicht in der Benutzeroberfläche. Das Design eines Dashboards kann sich vollständig ändern. Ein Kunde, eine Buchung oder eine Bestellung repräsentiert weiterhin dieselbe Entität. Wenn du zuerst über das Datenmodell nachdenkst, lässt sich auch das Frontend später leichter weiterentwickeln.
SQL, Postgres und Supabase: Was du dir wirklich merken musst
Wenn du gerade erst anfängst, musst du dir nicht Dutzende Begriffe einprägen.
Behalte diesen Zusammenhang im Hinterkopf:
SQL → die Sprache zum Abfragen und Ändern von Daten Postgres → die relationale Datenbank, die Daten speichert und Abfragen ausführt Supabase → die Backend-Plattform, die Postgres verwendet und Authentifizierung, Speicher, APIs, Funktionen und Werkzeuge für die Entwicklung von Webanwendungen ergänzt
In Coderblock sind diese Konzepte in den Prozess der App-Entwicklung integriert. Du kannst in natürlicher Sprache beschreiben, was sich deine Anwendung merken muss, wie die Daten miteinander verknüpft werden sollen und wer darauf zugreifen darf. Der Agent kann die Full-Stack-Implementierung übernehmen, während du das Ergebnis im Chat überprüfst und verfeinerst.
Wenn du verstehst, wie Datenbanken funktionieren, kannst du etwas noch Wichtigeres tun: klarer beschreiben, was du entwickeln möchtest. Du musst nicht unbedingt selbst SQL schreiben. Wenn du jedoch weißt, was Tabellen, Beziehungen, Rollen, Constraints und Berechtigungen sind, kannst du aus einer Idee eine Anwendung machen, die Daten nicht nur anzeigt, sondern sie tatsächlich speichert, verknüpft und schützt.