Las API REST explicadas para no desarrolladores
Una API REST es un sistema estructurado que permite a aplicaciones y servicios intercambiar información a través de la web. Descubre cómo funcionan las solicitudes, las respuestas, los endpoints, la autenticación y los errores, y qué debes tener en cuenta al planificar funcionalidades basadas en API.
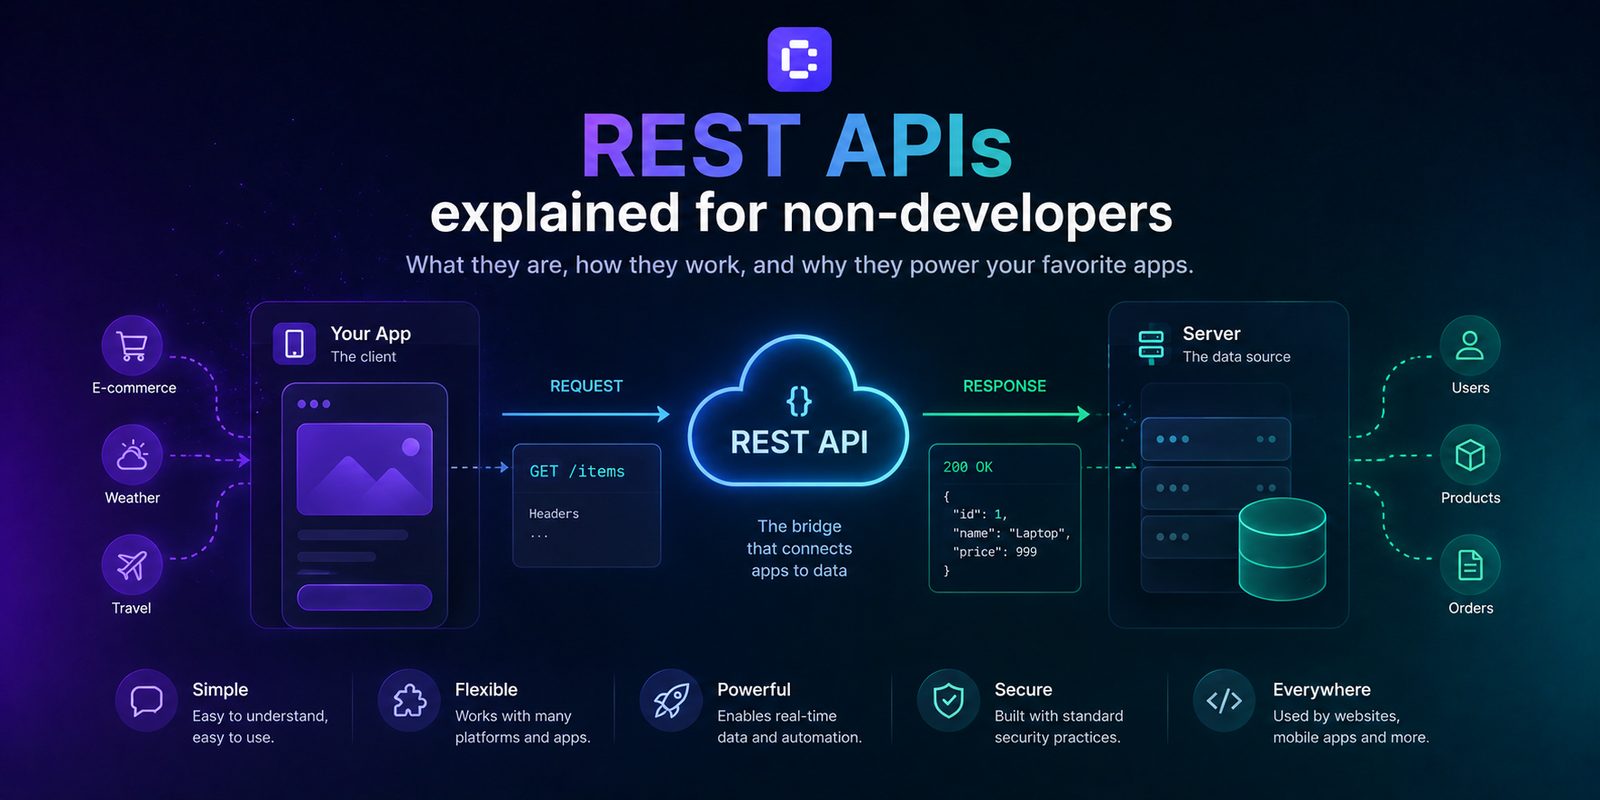
¿Qué es una API REST?
 Cuando utilizas una aplicación, gran parte de la información que ves en pantalla procede de servicios externos.
El tiempo en tu destino, el estado de un envío, el precio de un producto, una reserva o el resultado de un pago: a menudo, la aplicación no gestiona directamente todos estos datos, sino que los solicita a otros sistemas.
Aquí es donde entran en juego las API. Una API permite que dos sistemas de software se comuniquen mediante un conjunto de reglas definidas. Una API REST es una de las formas más habituales de hacerlo a través de la web. Puedes imaginarla como una conversación estructurada entre aplicaciones:
«Dame la información sobre este producto».
El servicio responde:
«Aquí tienes el nombre, el precio y la disponibilidad».
O bien:
«Crea una nueva reserva para este cliente».
Y el servicio podría responder:
«Reserva creada».
REST significa Representational State Transfer. No necesitas memorizar el acrónimo para entender cómo funciona. La idea central es más sencilla: una API REST organiza los datos en recursos, como usuarios, productos, pedidos o reservas, y define una forma estándar de consultarlos, crearlos, actualizarlos o eliminarlos.
Un ejemplo del mundo real
Imagina una aplicación de viajes que muestra el tiempo en el destino que estás a punto de visitar. La aplicación no tiene por qué recopilar y actualizar por sí misma todos los datos meteorológicos. Puede enviar una solicitud a la API de un servicio meteorológico.
El flujo es el siguiente:
Tu aplicación → solicitud a la API → servicio meteorológico → respuesta → tu aplicación
La respuesta podría incluir la temperatura, las condiciones meteorológicas y el pronóstico para los próximos días. El usuario simplemente ve el tiempo. Sin embargo, detrás de esa pantalla hay dos sistemas comunicándose.
La analogía del restaurante
Una forma sencilla de entender una API es imaginar que estás en un restaurante.
- Tú eres la aplicación que quiere algo.
- El menú describe lo que puedes pedir.
- El camarero recoge la petición y trae la respuesta.
- La cocina es el servicio que realiza el trabajo.
La API actúa a la vez como el menú y el camarero. Te indica qué puedes pedir, cómo debes realizar la solicitud y qué tipo de respuesta puedes esperar. No necesitas saber cómo funciona la cocina para pedir un plato. Del mismo modo, una aplicación no tiene por qué saber cómo está implementado internamente un servicio para utilizar su API.
¿Cómo funciona una solicitud a una API REST?
Cada solicitud a una API contiene algunos elementos esenciales.
Endpoint: dónde enviar la solicitud
El endpoint es la dirección a la que se envía la solicitud. Por ejemplo:
https://api.example.com/products/42
Esta dirección podría representar el producto con el ID 42. Los distintos endpoints pueden representar una colección de recursos, un elemento concreto o una operación específica.
Método HTTP: qué quieres hacer
El método HTTP indica al servicio qué operación quieres realizar. Los métodos más habituales son:
- GET → consultar información;
- POST → crear un nuevo recurso;
- PUT o PATCH → actualizar un recurso existente;
- DELETE → eliminar un recurso.
Por ejemplo, en una plataforma de reservas:
GET /bookings
podría consultar las reservas, mientras que:
POST /bookings
podría crear una nueva. Estas convenciones se utilizan de forma generalizada, pero no constituyen una garantía absoluta. La documentación de la API es siempre la referencia definitiva.
Encabezados y cuerpo: información adicional
Los encabezados contienen información complementaria para la solicitud, como el formato de los datos o las credenciales utilizadas para la autenticación. El cuerpo, por su parte, contiene los datos necesarios para realizar la operación. Por ejemplo, si quieres crear una reserva, el cuerpo podría contener:
{
  "service": "Consultation",
  "date": "2026-09-15",
  "time": "14:00"
}
Estos datos suelen representarse en JSON, un formato muy utilizado porque está estructurado y resulta fácil de leer tanto para las personas como para el software.
¿Qué ocurre cuando llega la respuesta?
Después de recibir la solicitud, el servicio la procesa y devuelve una respuesta. Por lo general, la respuesta contiene los datos solicitados o el resultado de la operación, junto con un código de estado HTTP que indica qué ha ocurrido. Los códigos más habituales se dividen en tres grandes categorías.
200–299: todo está bien
La solicitud se ha procesado correctamente. Por ejemplo:
200 OK→ solicitud completada;201 Created→ nuevo recurso creado.
400–499: hay un problema con la solicitud
El problema suele estar relacionado con la propia solicitud o con los permisos del cliente. Por ejemplo:
400 Bad Request→ datos no válidos;401 Unauthorized→ autenticación ausente o no válida;403 Forbidden→ el usuario no tiene los permisos necesarios;404 Not Found→ el recurso solicitado no existe.
500–599: problema en el servidor
El servicio encargado de procesar la solicitud ha encontrado un problema.
Sin embargo, para los usuarios, un código como 409 o 500 no significa gran cosa.
Por eso, una buena aplicación transforma el error técnico en un mensaje claro:
«Esta cita ya no está disponible. Elige otro horario».
es mucho más útil que:
«HTTP 409 Conflict».
API REST, bases de datos, webhooks y GraphQL: ¿cuál es la diferencia?
Estas tecnologías y conceptos están relacionados, pero cumplen funciones distintas.
API REST y bases de datos
Una base de datos almacena información. Una API, en cambio, define cómo pueden interactuar otros sistemas con esa información. Por ejemplo, una base de datos podría contener:
- usuarios;
- productos;
- pedidos;
- reservas.
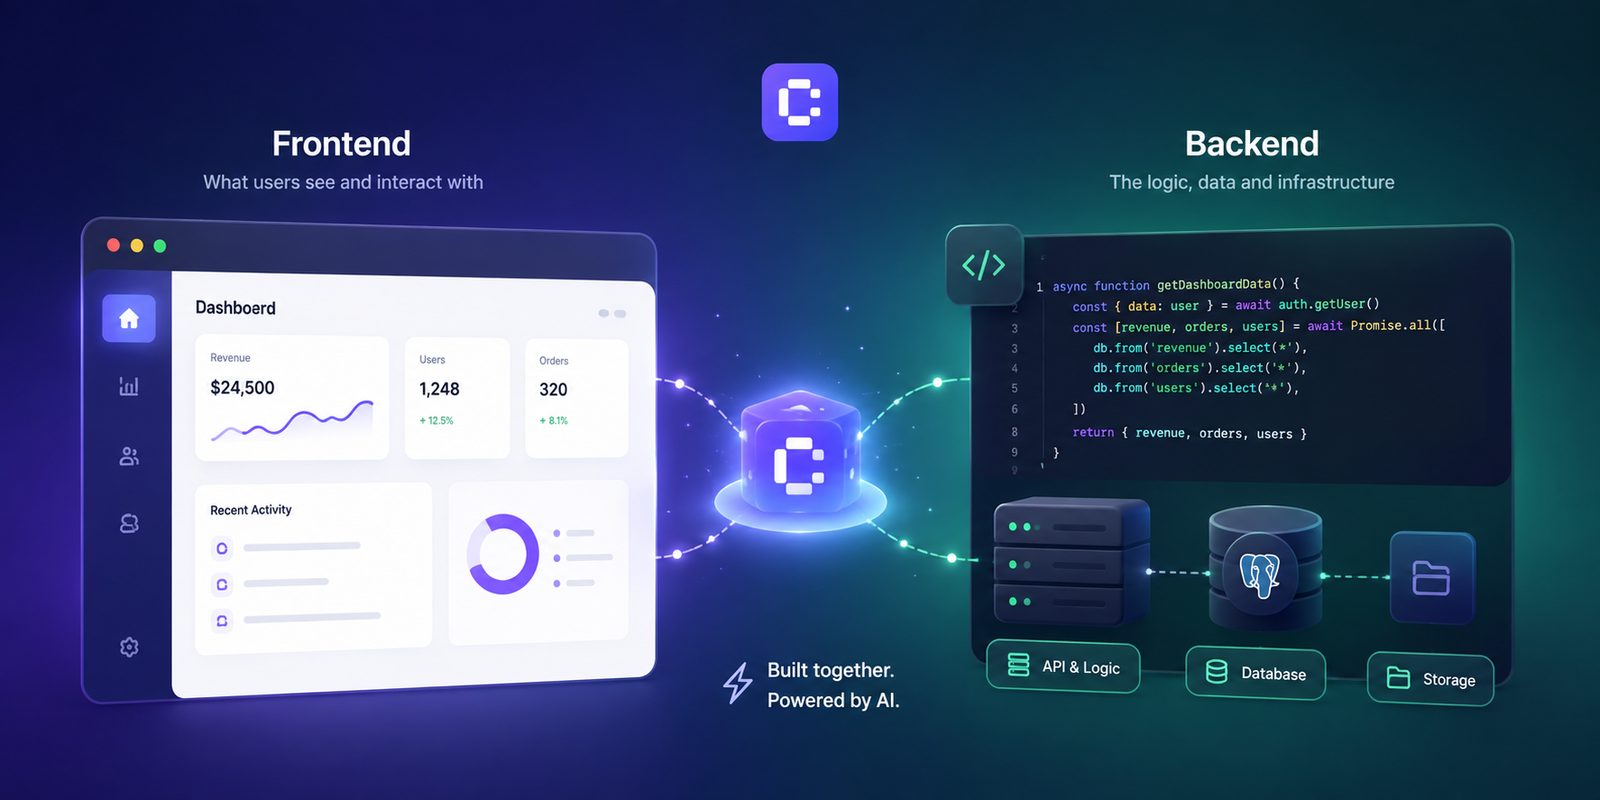
La API puede determinar qué datos se pueden consultar, crear o actualizar, y quién puede hacerlo. Esto crea una capa de control entre la aplicación y los datos. Conectar un navegador directamente a una base de datos sin las medidas de seguridad adecuadas podría exponer información u operaciones que deberían permanecer privadas. En Coderblock, el agente puede diseñar y aplicar un esquema de base de datos Postgres mediante una conversación. Las aplicaciones web estándar utilizan un proyecto dedicado de Supabase con Postgres, Auth, Storage y Row Level Security. La sección Backend también permite consultar tablas, usuarios autenticados, almacenamiento y funciones.
API REST y webhooks
Las API y los webhooks funcionan en direcciones diferentes. Con una solicitud estándar a una API, tu aplicación pregunta algo:
«¿Se ha completado correctamente el pago?»
Con un webhook, otro servicio informa de forma proactiva a tu aplicación de que ha ocurrido algo:
«El pago acaba de completarse correctamente».
Los webhooks son especialmente útiles para eventos que suceden más adelante, como pagos, actualizaciones de envíos o cambios en el estado de un pedido. Sin embargo, deben verificarse y gestionarse de forma segura. En el flujo gestionado de Stripe de Coderblock, la plataforma puede encargarse de configurar el webhook. En el modo BYOK, el agente solicita de forma segura la clave secreta de Stripe y configura automáticamente el webhook.
REST y GraphQL
REST y GraphQL son dos enfoques diferentes para la comunicación entre aplicaciones. Con REST, normalmente se trabaja con varios endpoints que representan distintos recursos. GraphQL, en cambio, utiliza una interfaz de consultas mediante la cual el cliente puede especificar exactamente qué datos quiere recibir. GraphQL puede resultar especialmente útil cuando los requisitos de datos son complejos y el cliente necesita un mayor control sobre la respuesta. REST, por su parte, está ampliamente extendido y suele ser más fácil de entender. Sin embargo, ninguno de los dos enfoques es siempre mejor que el otro. La elección adecuada depende de la arquitectura del servicio, los requisitos del producto, el equipo y el tipo de cliente que vaya a utilizarlo.
Autenticación y autorización no son lo mismo
Hay dos conceptos que suelen confundirse: autenticación y autorización. La diferencia es sencilla. Autenticación:
«¿Quién eres?»
Autorización:
«¿Qué tienes permitido hacer?»
Imagina una plataforma con clientes y administradores. Iniciar sesión permite verificar que realmente eres un usuario determinado. Pero eso no significa automáticamente que puedas ver todos los datos de la aplicación. Un cliente podría ver sus propias reservas. Un administrador podría ver las reservas de todos los clientes. La identidad subyacente es el mismo tipo de información, pero los permisos son diferentes.
¿Qué ocurre con las claves de API?
Una clave de API suele identificar a la aplicación o al servicio que realiza una solicitud. Una sesión autenticada, por su parte, puede identificar al usuario que ha iniciado sesión. Ninguna de las dos debe tratarse como un pase universal.
Los permisos deben definirse por separado y aplicarse también en el servidor o en la base de datos. En Coderblock, puedes pedir directamente en el chat:
«Añade inicio de sesión y cuentas de usuario».
El agente puede configurar Supabase Auth, páginas de registro e inicio de sesión, gestión de sesiones, rutas protegidas y Row Level Security vinculada al usuario autenticado. Las aplicaciones también incluyen una estructura básica para perfiles y roles. Esto significa que no necesitas crear manualmente una tabla de contraseñas ni implementar desde cero la lógica de autenticación.
¿Dónde deben almacenarse las claves de API?
Las credenciales privadas son otro aspecto crítico. Una clave secreta de API no debe incluirse en el frontend, publicarse en GitHub ni almacenarse en un campo al que puedan acceder los usuarios. Cuando un proyecto de Coderblock necesita un secreto, el agente puede obtenerlo mediante una solicitud segura de variables de entorno. El valor se almacena en el repositorio de secretos del servidor del proyecto y no se añade al código del frontend ni a la conversación.
Cómo diseñar una funcionalidad que utiliza una API
Al crear una aplicación con una herramienta de IA, no es necesario empezar por la tecnología. Empieza por el resultado que quieres ofrecer al usuario. «Mostrar a los clientes el estado de entrega de su pedido» resulta más útil que:
«Añade una API».
A partir de ahí, puedes definir qué necesitas.
1. Identifica la fuente de los datos
¿Qué sistema contiene la información correcta? ¿Tu base de datos? ¿Un servicio externo? ¿Stripe? ¿Un sistema de gestión de envíos? Debe existir una única fuente de verdad claramente definida.
2. Consulta la documentación
Antes de integrar un servicio, comprueba:
- los endpoints disponibles;
- los métodos de autenticación;
- los entornos de prueba;
- los límites de uso;
- los formatos de las solicitudes y las respuestas;
- si admite webhooks.
3. Planifica la gestión de errores
¿Qué ocurre si el servicio externo responde con lentitud? ¿Y si deja de estar disponible temporalmente? ¿Qué pasa si devuelve datos incompletos? Una aplicación bien diseñada debe tener un comportamiento definido incluso cuando una API no responde como se esperaba.
4. Valida los datos entrantes y salientes
No des por hecho que todo lo recibido de un servicio externo es siempre correcto. Los datos deben validarse antes de utilizarlos o almacenarlos.
5. Limita los permisos
Una integración solo debe tener el acceso que realmente necesita. Si un servicio necesita consultar pagos, eso no significa necesariamente que también deba poder modificarlos.
6. Protege los secretos
Las credenciales privadas deben permanecer en el servidor. El navegador nunca debe recibir una clave de API capaz de realizar operaciones restringidas.
7. Haz pruebas antes de pasar a producción
Siempre que sea posible, utiliza el entorno de pruebas del servicio. No pruebes únicamente las operaciones correctas, sino también las solicitudes rechazadas, los errores, los tiempos de espera agotados, los duplicados y las cancelaciones.
8. Evita solicitudes innecesarias
No toda la información debe solicitarse cada vez que se carga una página. Cuando los datos lo permitan, el almacenamiento en caché puede reducir los tiempos de respuesta, el número de solicitudes y los costes de la integración.
Trabajar con API en Coderblock
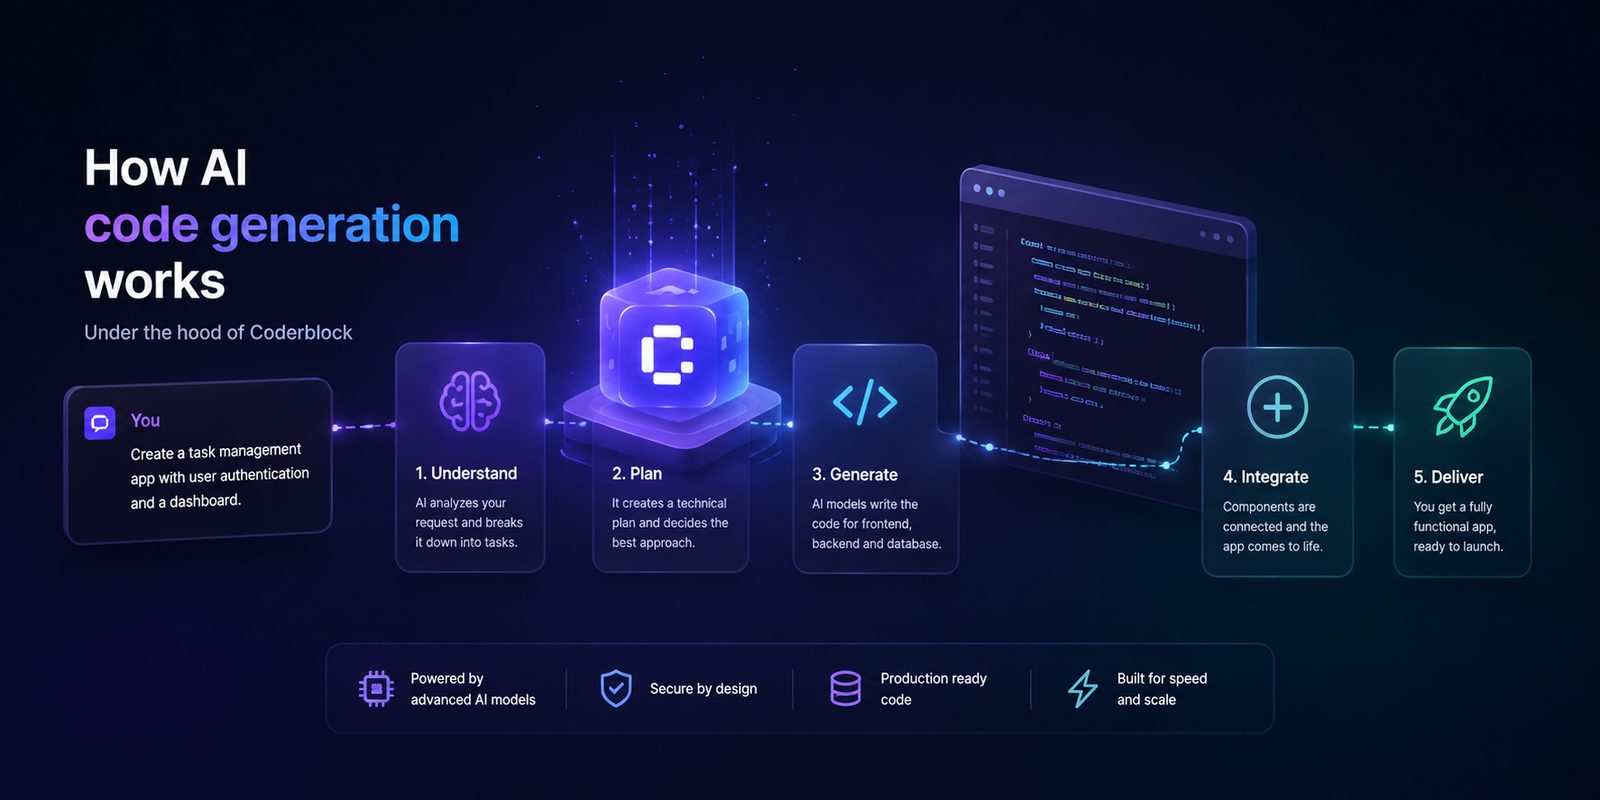
Con Coderblock, las API pasan a formar parte del mismo flujo de trabajo conversacional que se utiliza para crear el resto de la aplicación. Puedes empezar con una idea o una plantilla de producto y pedir a la IA que cree el frontend, el backend y la base de datos.
Cuando quieras añadir una integración, conviene describir el comportamiento que deseas. Por ejemplo:
«Añade acceso mediante cuenta. Cada cliente solo debe poder ver sus propias reservas. Si el servicio externo de programación de citas no está disponible, muestra un mensaje claro y permite que el usuario vuelva a intentarlo».
Una solicitud como esta no solo comunica qué tecnología utilizar, sino, sobre todo, qué debe ocurrir en la aplicación.
El agente puede encargarse de la implementación subyacente mientras tú revisas el resultado en la vista previa en directo de coderblock.dev y sigues perfeccionándolo mediante el chat.
Por qué es útil entender las API aunque no sepas programar
No necesitas ser desarrollador para comprender el concepto de una API REST. Pero conocer los fundamentos cambia la forma en que diseñas una aplicación. Te ayuda a entender por qué una integración con Stripe es diferente de una conexión a una base de datos, por qué un webhook no es lo mismo que una solicitud estándar a una API y por qué una clave de API nunca debe quedar expuesta en el frontend. Y, lo más importante, te ayuda a escribir mejores instrucciones para la IA.
En lugar de pedir simplemente:
«Añade una API».
puedes describir qué debe ocurrir, qué datos deben utilizarse, quién puede acceder a ellos y qué debería pasar cuando algo sale mal. La IA puede encargarse de gran parte de la complejidad técnica.
Pero cuanto más claramente puedas describir el comportamiento que deseas, mayor será el control que tendrás sobre el producto que estás creando.